导读:阅读本文你将获得:
- 看清知识库「悄悄学坏」的四个步骤
- 明白为什么四个评估指标全绿、答案却还是错的
- 一组企业知识工程的真实水位数字(附出处)
- 一套不花预算的知识体检法:三个固定问题
- 一次我们自己做的知识体检,真实数字全公开
「你们最近一次注销文档,是什么时候?」
我把这个问题抛给一位做工业设备的朋友。他管着一套 1.2 万份文档的企业知识库,检索引擎跑得很稳,测试集全绿,AI 的回答也漂亮得像模像样。
他愣了几秒才回答:从来没有注销过,只加不删。
这个回答的普遍程度超出你的想象。我们接触过的企业里,把知识库当仓库管的是绝对多数——建的时候倾注全部精力,建完之后就交给时间。而时间做的事,恰恰是让仓库里的东西变质。
我的判断很直接:企业 AI 落地失败,多数时候不是模型不行,是知识没有「保质期」这个概念。
一、AI 用得多,落地得少
先看四个数字。
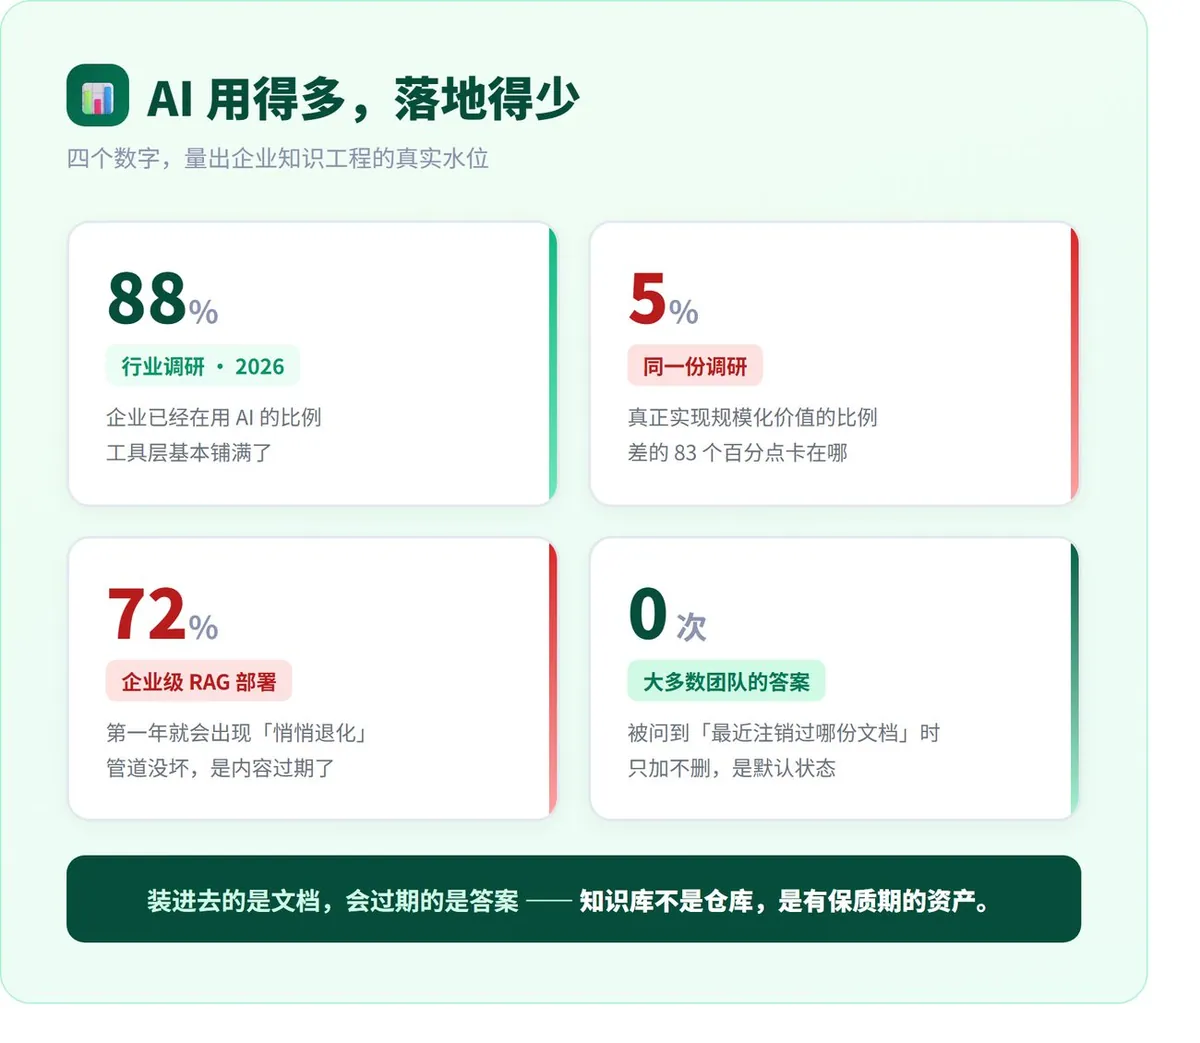
88% 的企业已经在用 AI,但只有 5% 真正实现了规模化价值。中间那 83 个百分点,行业里有个不太客气的说法:大部分人买到的是工具,不是结果。
更值得盯的是第三个数字:72%。这个比例的企业级 RAG 部署,会在上线第一年遇到同一种病——系统开始「悄悄退化」。
注意是「悄悄」。它不是报错、不是宕机,是答得越来越自信、越来越不对。
第四个数字 0,是我们自己一家家问出来的:被问到「最近注销过哪份文档」,大多数团队的答案是零。
这个零,就是那 83 个百分点的答案。
二、知识库是怎么悄悄坏掉的
四个步骤,全程没有任何一步会报警。
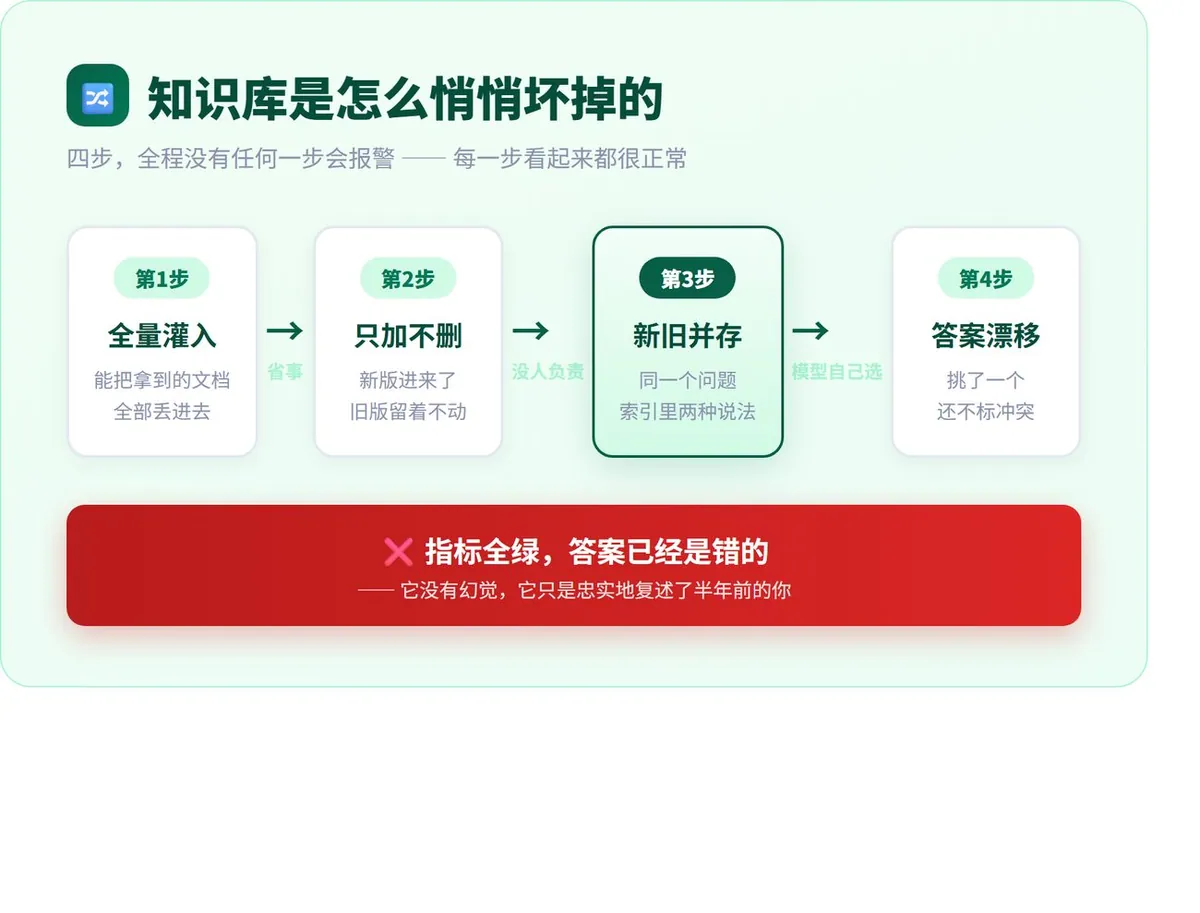
第 1 步,全量灌入。Notion 导出、Confluence 转储、共享盘、PDF 文件夹——全部加载、分块、嵌入、发布。这一步看起来叫「充分利用存量」,实际上是把整理问题往后推。
第 2 步,只加不删。新版的流程文档进来了,旧版留在原地。没人负责这件事,因为「删」在组织里不是个受欢迎的动作——删错了要担责,不删没人问。
第 3 步,新旧并存。同一个问题,索引里躺着两种说法。2022 年的入职指南和 2025 年的流程更新并排待着,两份都会被检索到。
第 4 步,答案漂移。模型拿到互相矛盾的信号,通常会直接选一个,而且不标冲突。你最后拿到的是:语气确定、格式漂亮、引用真实文档,只是那份文档已经不作数了。
有一个数字我觉得很扎心:一条忠实度评分 0.95 的流水线,在索引过期八个月的情况下,依然会稳定地给出错误的业务答案。
它没有幻觉。它只是忠实地复述了半年前的你。
三、为什么所有仪表盘都是绿的
问题的根,藏在评估指标的定义里。
业内标准的 RAG 评估看四个指标:忠实度(有没有准确表达检索到的内容)、答案相关性(有没有回答到点上)、上下文精度(检索来的材料相不相关)、上下文召回率(该找的材料找齐了没有)。
这四个指标都有用。但它们共享一个从未被质疑的假设:检索索引本身是可信的。
没有一个指标在问:检索到的内容,现在还对不对?
所以会出现一种非常危险的状态——四项分数全部接近满分,答案在现实世界里彻底错误。因为指标是相对「知识库」打分的,不是相对事实打分的。
斯坦福大学做过一项法律领域的 RAG 研究,结论是这类幻觉「大量的、广泛的、且具有潜在隐蔽性」。更麻烦的是后半句:「引用」这个本来用来建立信任的机制,反而会增强错误的信心——它营造出「信息经过验证」的假象,底下却什么支撑都没有。
这就是为什么这类问题通常不是靠监控发现的。指标好看,日志干净,告警不响。信号最后出现在用户投诉、升级率和支持工单里——而那时候,问题已经发生了好几个月。
能被监控看见的故障,都不是最危险的故障。最危险的那一类,长得像一切正常。
四、管知识库,从来不是技术问题
把这些案例翻回来,会发现一个共同点:出问题的团队,几乎都把知识库当成「配置」——设置一次,偶尔更新,然后基本就忘了。
但更贴切的类比不是配置,是一个面向客户实时查询的数据库。每一条过时的记录,都是一个潜在的错误答案。而当用户拿到了关于你产品的错误信息,没有事务回滚这一说。
仓库、冰箱、药房,是三种管法。
仓库只管堆得下,不问新旧——这是多数企业现在的状态。
冰箱会扔东西,但扔得凭印象,没有台账——这是稍微讲究一点的团队。
药房不一样:每一盒都带有效期,过期先下架、再补货,整个过程可审计。
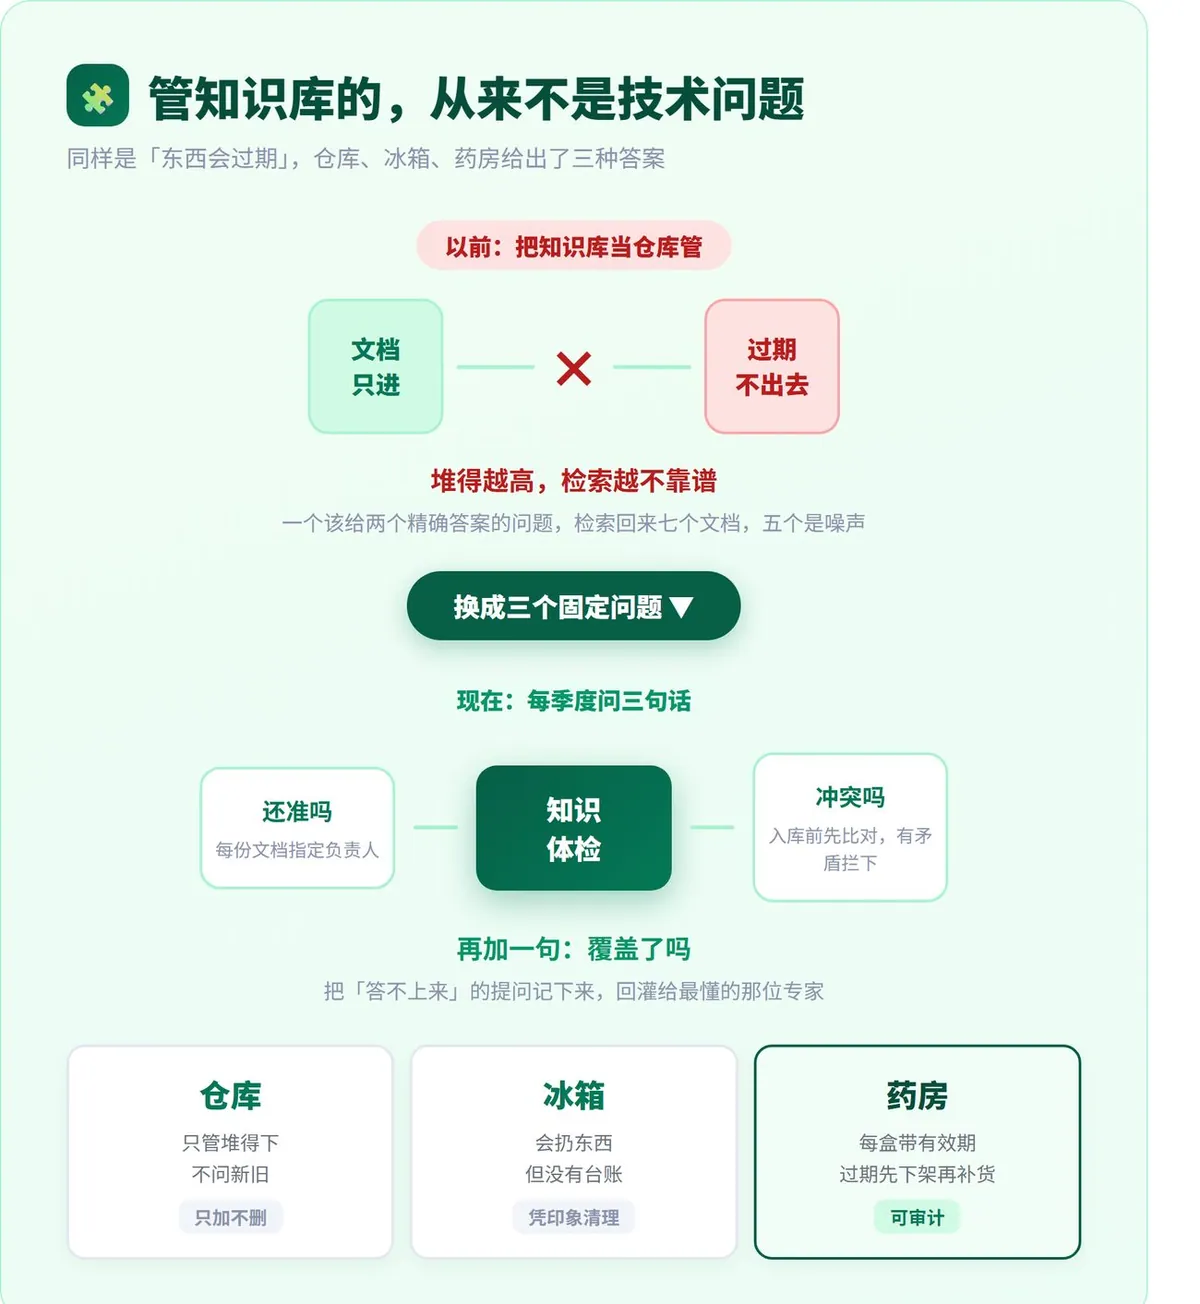
第一问:这些内容还准吗?给每份文档指定一个负责人,通常是了解内容是否反映现状的那位领域专家。关键是审查必须是日历上的一个具体事件,不能是「大家记得看」。
第二问:这些内容互相冲突吗?冲突文档是最难靠人工发现的一类故障。做法是入库前先跟已有内容比对,在进索引之前就拦下来。
第三问:覆盖了用户真正在问的吗?把检索置信度低的问题日志记下来,那就是内容覆盖缺口的地图。转到对应的领域专家手里,闭环就成立了。
还有一个动作值得单独说:墓碑式注销。
废弃的文档不要直接删,而是标记为「以前适用、现已被取代」。这样模型可以说「这个规则曾经有效,但已经更新了」,而不是给一个过期答案。删掉是失忆,墓碑是记得改过。
五、我们自己做了一次知识体检
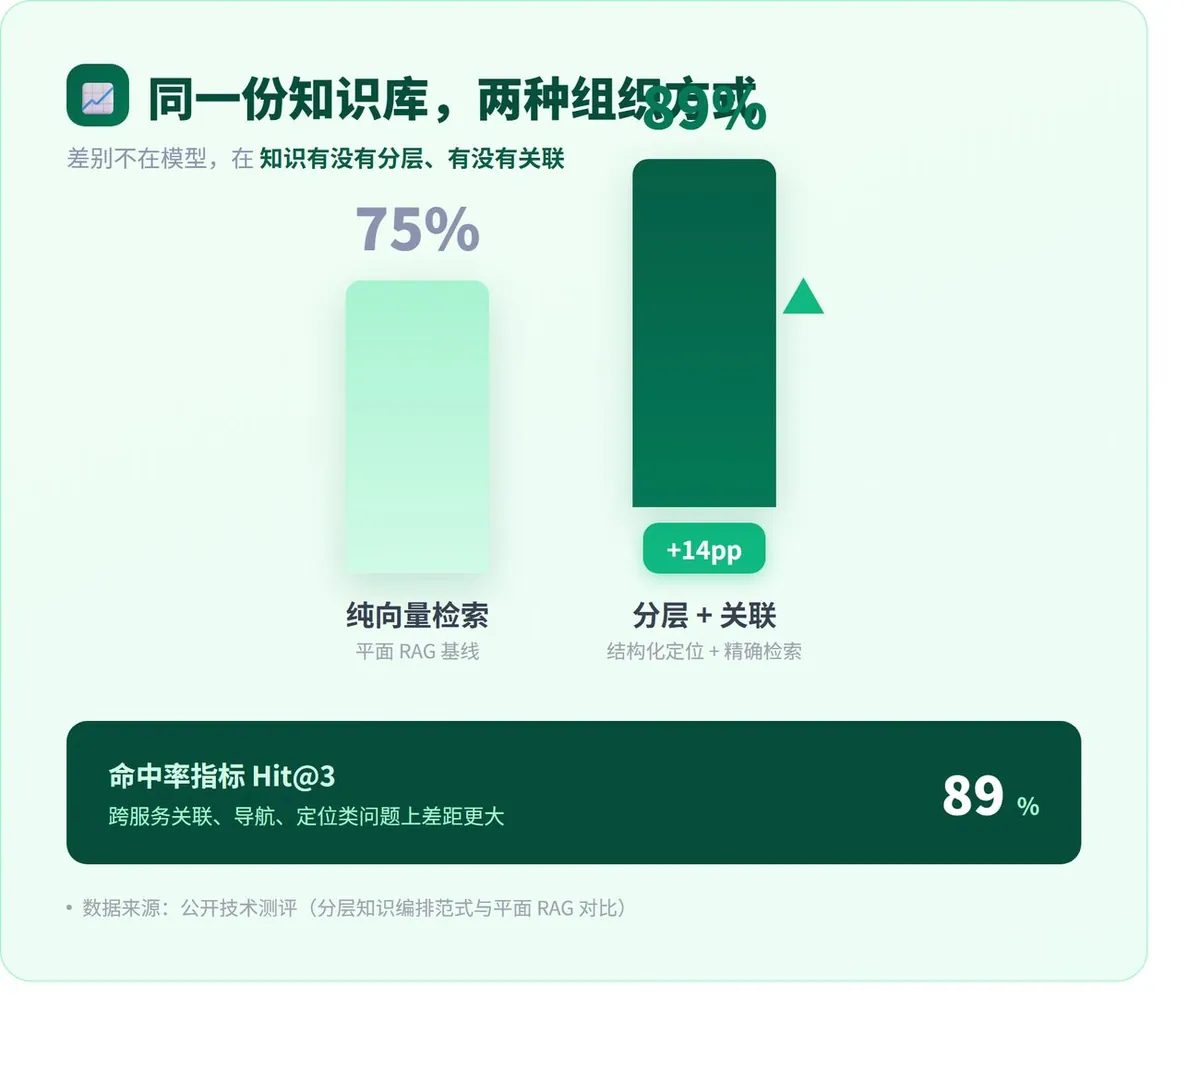
说别人容易,说自己也一样。我们自己的 AI 团队跑的就是这套逻辑,所以我拿它做了一次基准测试:100 道题,同一批内容,只改检索与判定方式。
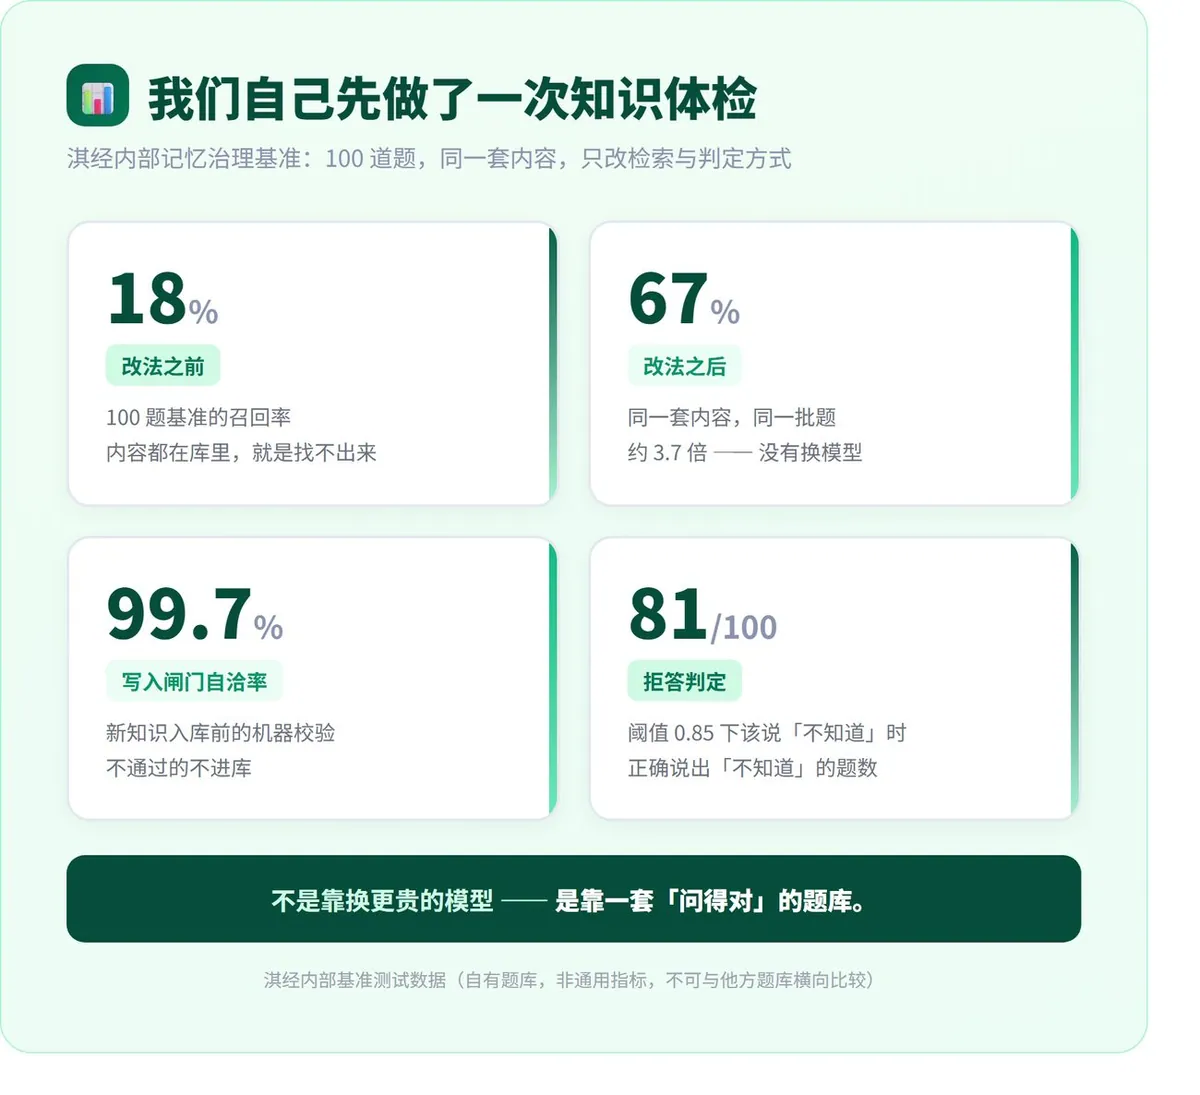
改法之前,召回率 18%——内容都在库里,就是找不出来。
改法之后,同样 100 道题,召回率 67%,约 3.7 倍。这中间没有换模型,改的是内容的组织方式和检索策略。
另外两个数字:知识入库前的机器校验自洽率 99.7%(过不了闸门的不进库);拒答判定在阈值 0.85 下,该说「不知道」的时候,81 道题正确说出了「不知道」。
我特别看重最后这个 81。因为让 AI 说「我不知道」,比让它多说三句正确答案要难得多。它需要触发阈值、需要判定逻辑,更需要有人愿意为「回答得少」负责。
举个我们最小的动作。每次整理,不是「把新内容加进去」,而是先把高价值细节下沉到二级库,再把留在主档里的删掉——先沉、再删。听起来是小事,但它把「只增不减」这个默认状态强行掰过来了。
顺便说一个很多人会踩的坑:几个岗位的智能体各有独立记忆,互相查不到对方的记录。这不是数据丢了,是设计——不该混的记忆混在一起,就是下一种知识污染。
六、明天就能做的三件事
不需要预算,不需要新工具,三件事今天就能排进日程。
第一件,做一次「注销盘点」。随便挑 20 份文档,问它们的负责人:这份还准吗?如果对方答不上来,或者说「应该还有个新版本」,那你真实的敞口就不是 20 份。
第二件,给每份核心文档指定一个活人。不是部门,是人名。部门负责的东西,最后往往就是没人负责。
第三件,把「答不上来」的问题记下来。如果你已经有客服机器人或内部问答,一定存在它答错或答不上来的记录。那些记录不是故障日志,是内容需求清单。
最后
回到开头那位朋友。那次聊完,他做的第一件事不是买新工具,而是让三个人分别认领了各自领域的一批文档,然后定了一个季度的审查日期。两个月后他告诉我:客服团队报上来的第一条问题是「我们手册里那个参数和官网写的不一样」——这个问题存在多久了,没人知道。
我们给 知名美国净水品牌 净水、谷轮热泵、爱优特做 AI 搜索优化的时候,交付清单的第一页从来不是内容排期,而是一张事实核对表——品牌全称、品牌沿革、产品口径、关键数据,先保证这些在所有地方是同一套说法。M77 那边我们也是同样的动作:先对齐事实,再谈曝光。
因为在 AI 面前,知识这件事没有「差不多」。
知识库和冰箱一样,问题从来不是装不下,是没人清。
而我们要的从来不是「AI 不胡说」——那不可能。我们要的是:它在该闭嘴的时候,闭嘴。
这话说起来简单,做起来需要一整套东西:给文档指定负责人、给内容设有效期、给答案设阈值、给「不知道」留位置。它不性感,也不热闹,但它决定了你的 AI 第二年还在不在岗。
如果你手上也有一套知识库,这篇文章里至少有一件事今天就能做:挑 20 份文档,问一句「这份还准吗」,然后把答不上来的那几份记下来。那份名单的价值,可能比你这个月新加的所有内容都高。
部分配图由AI生成