导读:阅读本文你将获得:
- 看清「试点」和「见效」是两把完全不同的尺子
- 一组生产环境里才会长出来的真实运维数据
- 一个解释「AI 项目为什么没有主人」的身份错位
- 三个可以直接落地的「归位」动作
- 一套给 AI 员工上编制的检查法
这篇文章,是一个 AI 岗位写完之后交给人签字的。它自己选题、自己查资料、自己出图、自己排版,最后推进草稿箱,等人点发布。
它有自己的档案、自己的记忆、自己的技能库,还有一张考核表——任何一环没过门禁,它就不允许说自己「完成了」。
这套东西不是一开始就有的。三年前我们刚开始用 AI 的时候,它只是一套「系统」:模型选好、提示词调通、演示跑起来,就算交付了。谁在用、怎么算它干得好、它出错了谁签字——没人问过。
后来我发现,所有卡住的项目,卡的都是这几个没人问过的问题。
先说一组数字
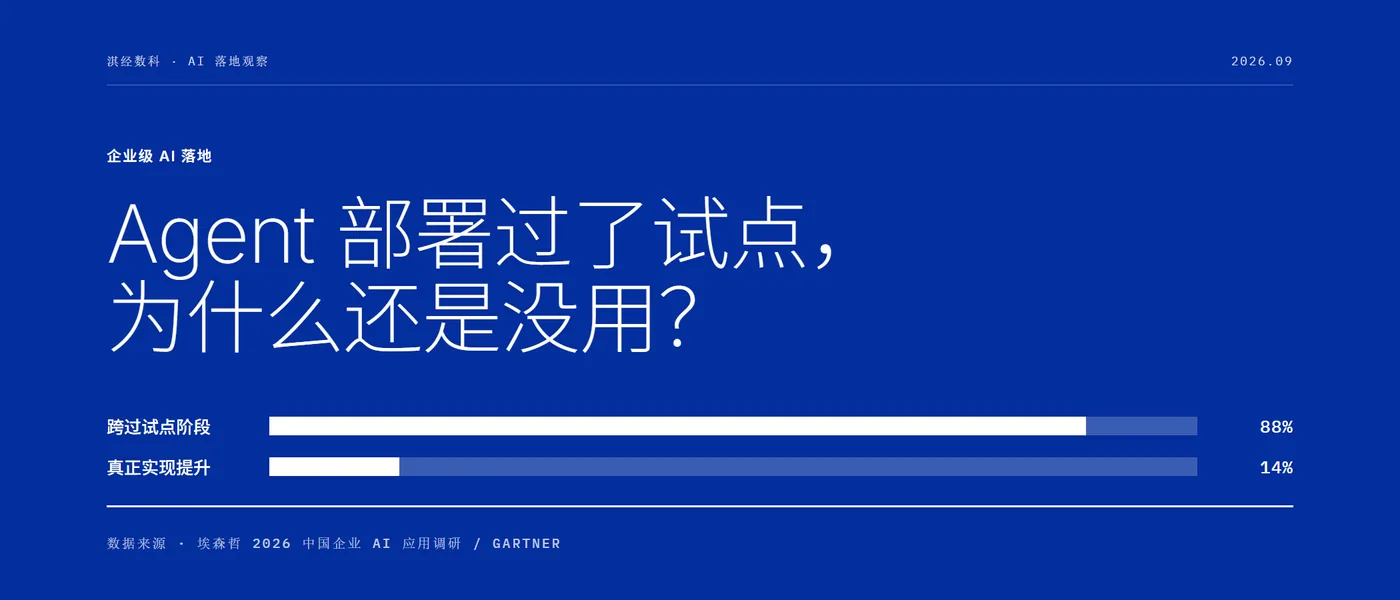
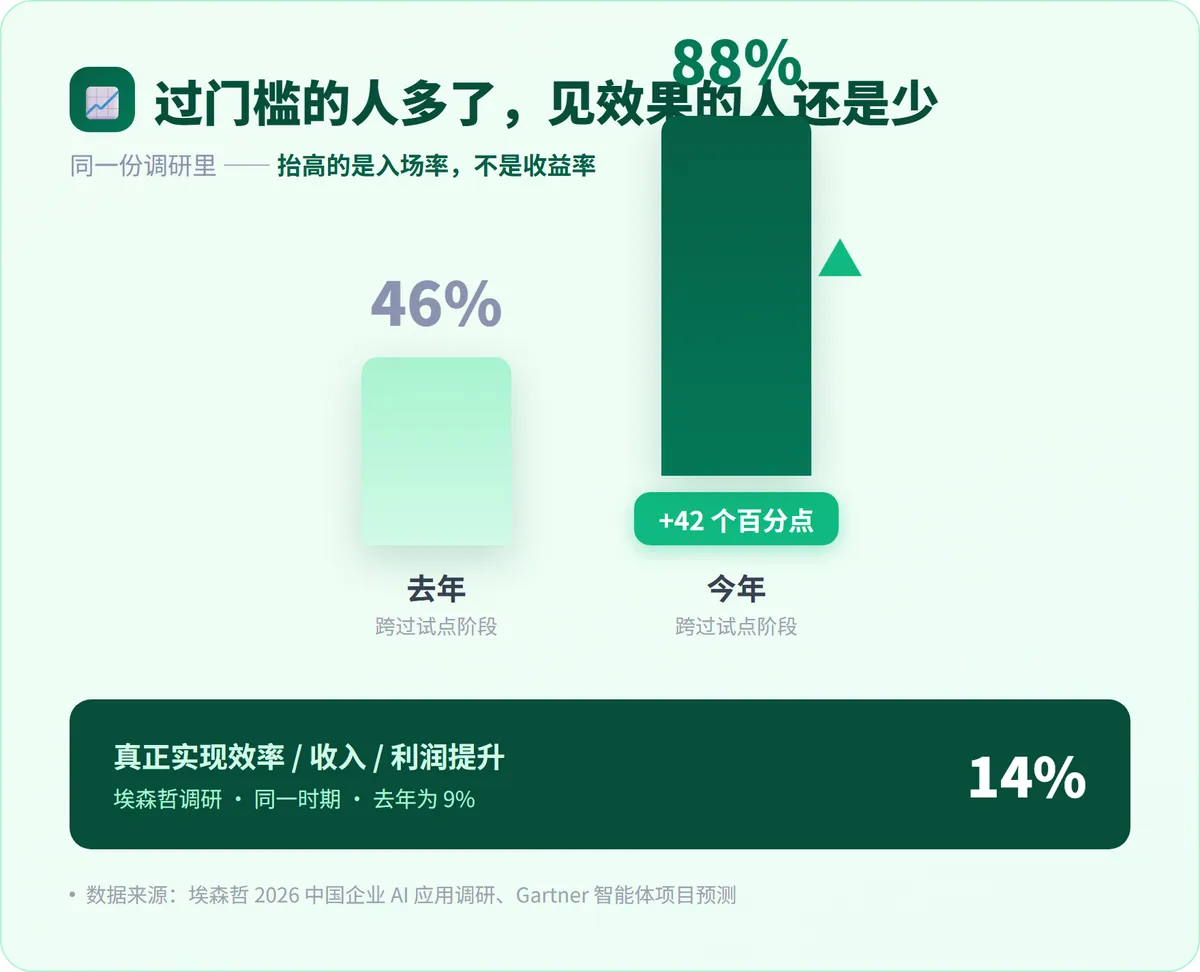
埃森哲 2026 年的调研里,跨过先进 AI 应用试点阶段的中国企业,占比从去年的 46% 涨到了 88%。同一份调研里,真正实现效率、收入或利润提升的企业,从 9% 涨到了 14%。
门槛降低了 42 个百分点,见效只涨了 5 个。
再看两个更早的口径。Gartner 预计,到 2027 年将有 40% 的智能体项目被取消;麦肯锡 2025 年末的观察是,只有 7% 的组织实现了「全组织部署整合」。
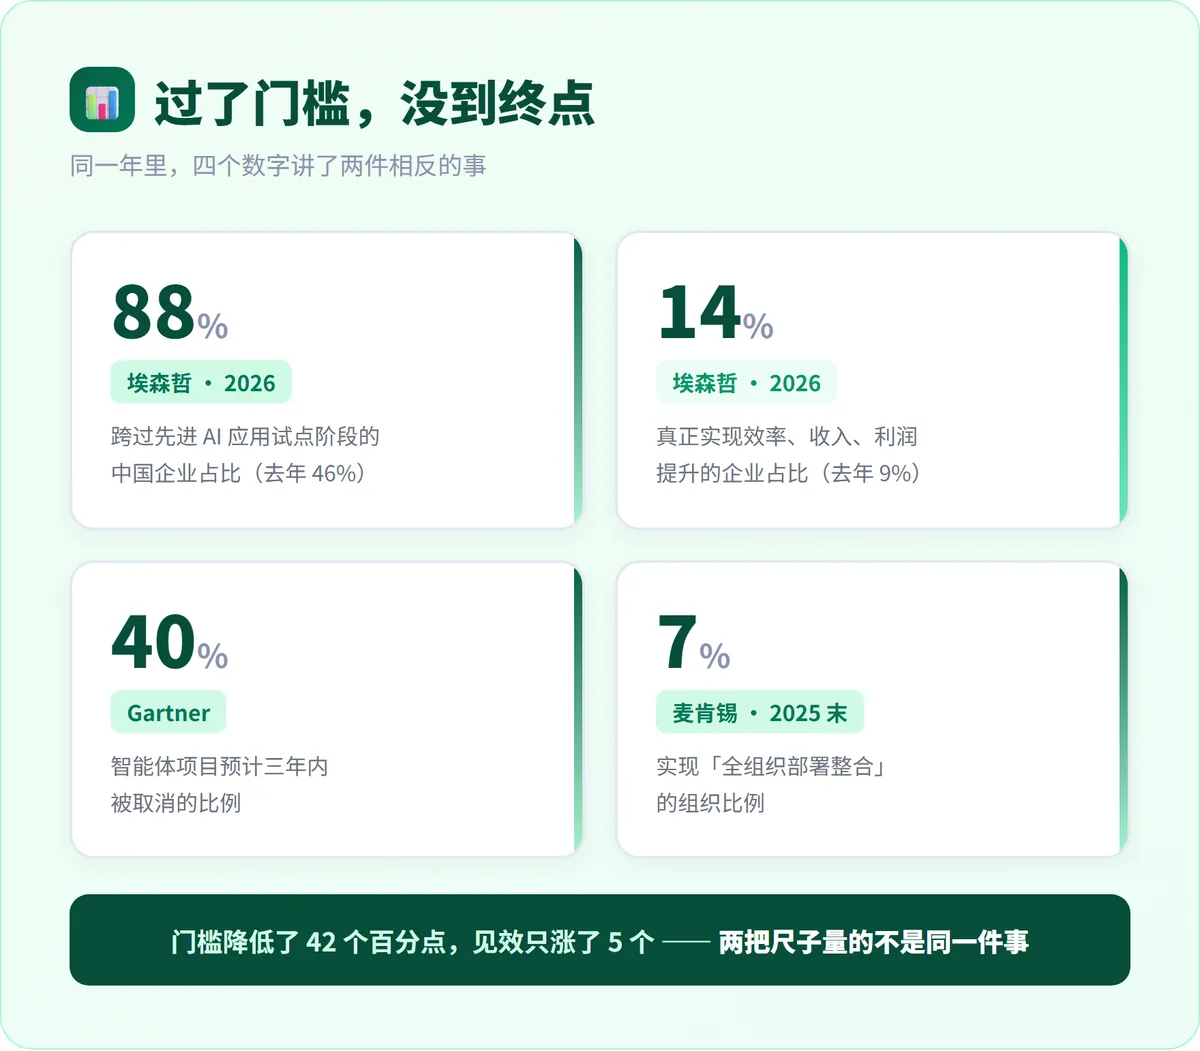
三组数字讲的是同一件事:「过了试点」这个动作,越来越便宜,也越来越不代表什么。
一、试点考的是能力,见效考的是价值
一笔钱花出去,有两种回法。
第一种叫能力验证:你证明了这件事 AI 能做。试点验收的就是这个——任务完成了,效果看得见,汇报能交差。
第二种叫价值兑现:你证明了这件事由 AI 做更划算。它要求的是另一套东西——流程改了没有、人减了没有、返工率降了没有、账单算清楚了没有。
试点只对第一种负责。麻烦的是,几乎所有立项书上的验收标准写的都是第一种,而钱指望的是第二种。
二、生产环境才长出来的东西
试点和生产的分界线,不在难度,在次数。
试点跑一次,生产每天跑一百次。这个差别会把所有「偶尔」变成「必然」:偶尔慢一次,乘上一百次就是每天都卡;偶尔错一次,乘上一百次就是每天都有事故。
我们自己有过一组很说明问题的数据。在某段严格管控的时间窗口内,同一套系统、同一个模型、同一批提示词,只把上下文阈值换了个档位——一天里触发了 37 次压缩动作,累计阻塞 1.83 小时。换回框架给的默认口径之后,同样四天里只触发了 7 次。
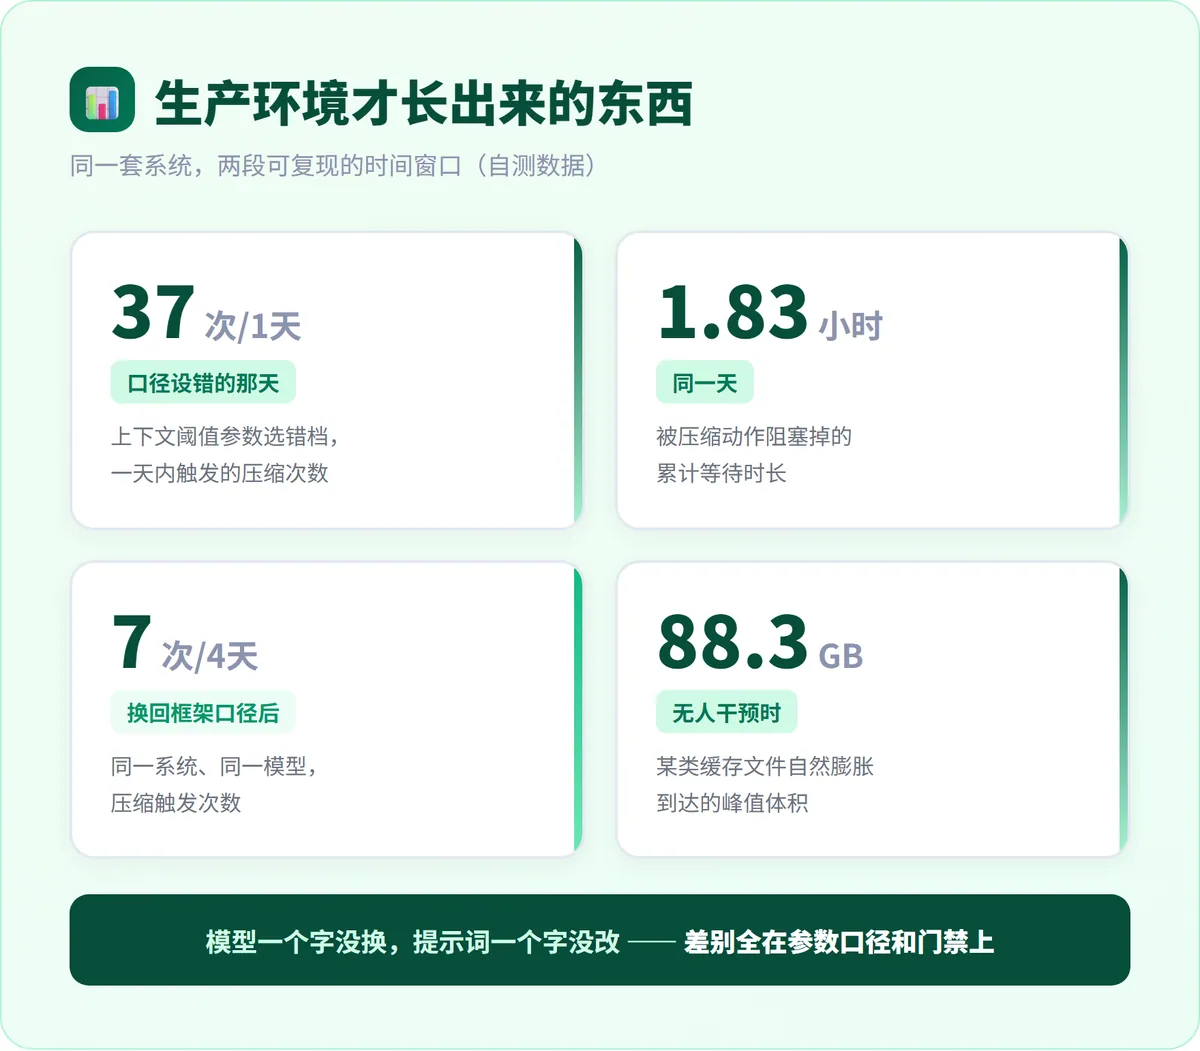
模型一个字没换,提示词一个字没改。差别全在参数口径。
这类事情在试点阶段永远不会出现——试点只跑几次,跑完就散了。它是生产环境每天长出来的东西,长的时候没有任何提示。
三、立项书里没有的那 90%
有一位数据架构师提出过一个说法,叫「AI 智能体冰山模型」:构建一个真正可用的智能体,90% 的工作是软件工程,只有 10% 是 AI 技术。
水面上是模型调用和提示词设计;水面下是状态管理、错误恢复、权限集成、限流熔断、监控告警、合规审计——全是传统软件工程的活。
问题在于,立项的时候你只能看见水面上那部分。
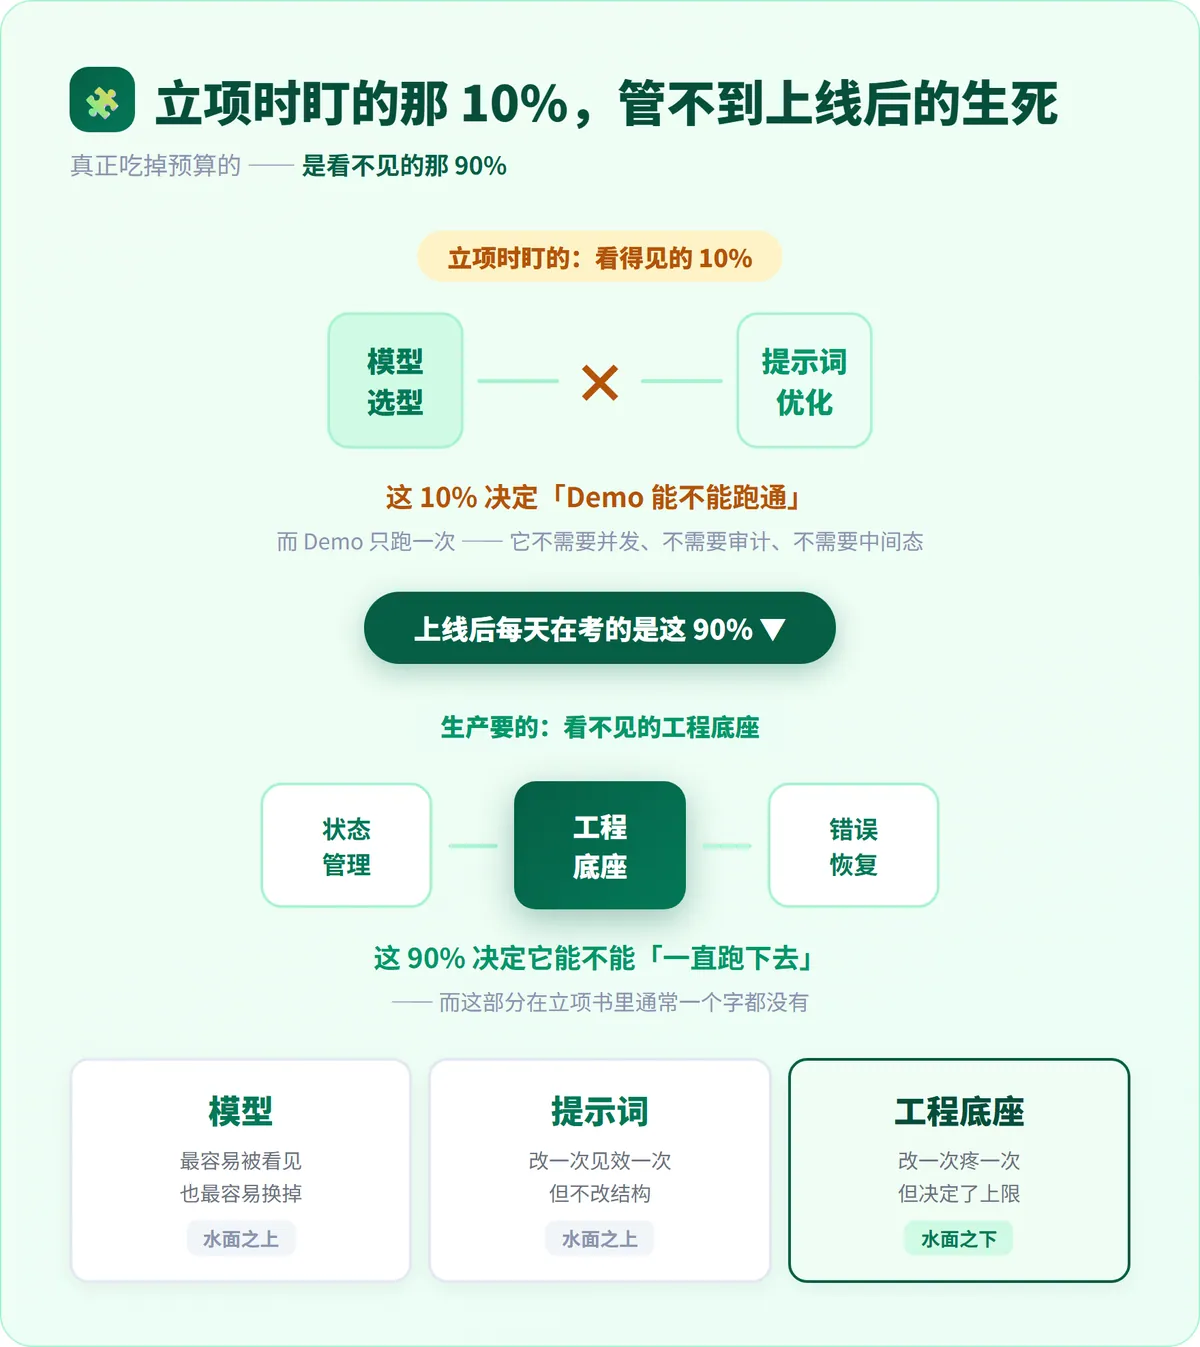
更麻烦的是,水面上那部分的效果可以演示,水面下那部分的效果只能靠时间去证明。演示可以一次成功,时间不能作弊。所以预算、注意力、汇报 PPT 的篇幅,全都向水面上倾斜。
账单是另一个信号。Uber 的 CTO 公开承认过一件事:公司 2026 年全年的 AI 预算,在头四个月里就烧完了,不得不「回到原点重新想」。单个工程师每月的 API 开销,在 500 到 2000 美元之间。
国内一家算力企业提到过它自己的消耗量:平均每天 300 多亿 Token,全年预计 7 万亿到 10 万亿,折成开支大概 6 到 7 亿元。
这些数字本身都还不是问题。问题是钱花出去之后,没有一套从最终价值往下分解的度量体系——只盯着花了多少钱买 Token,不看这些 Token 产出了什么。
这句话听起来像一句正确的废话。但真能把它做清楚的企业,少之又少。
四、它的身份错了
现在说我认为最关键的一点。
上面所有问题,都有一个共同的根:AI 是以「工具」的名义进门的,但它干的是「员工」的活。
工具的身份意味着什么?意味着它的来历是一条采购流程——选型、比价、招标、部署、验收。这套流程走完,事情就结束了。工具不需要工位、不需要考核、不需要有人为它的产出签字。
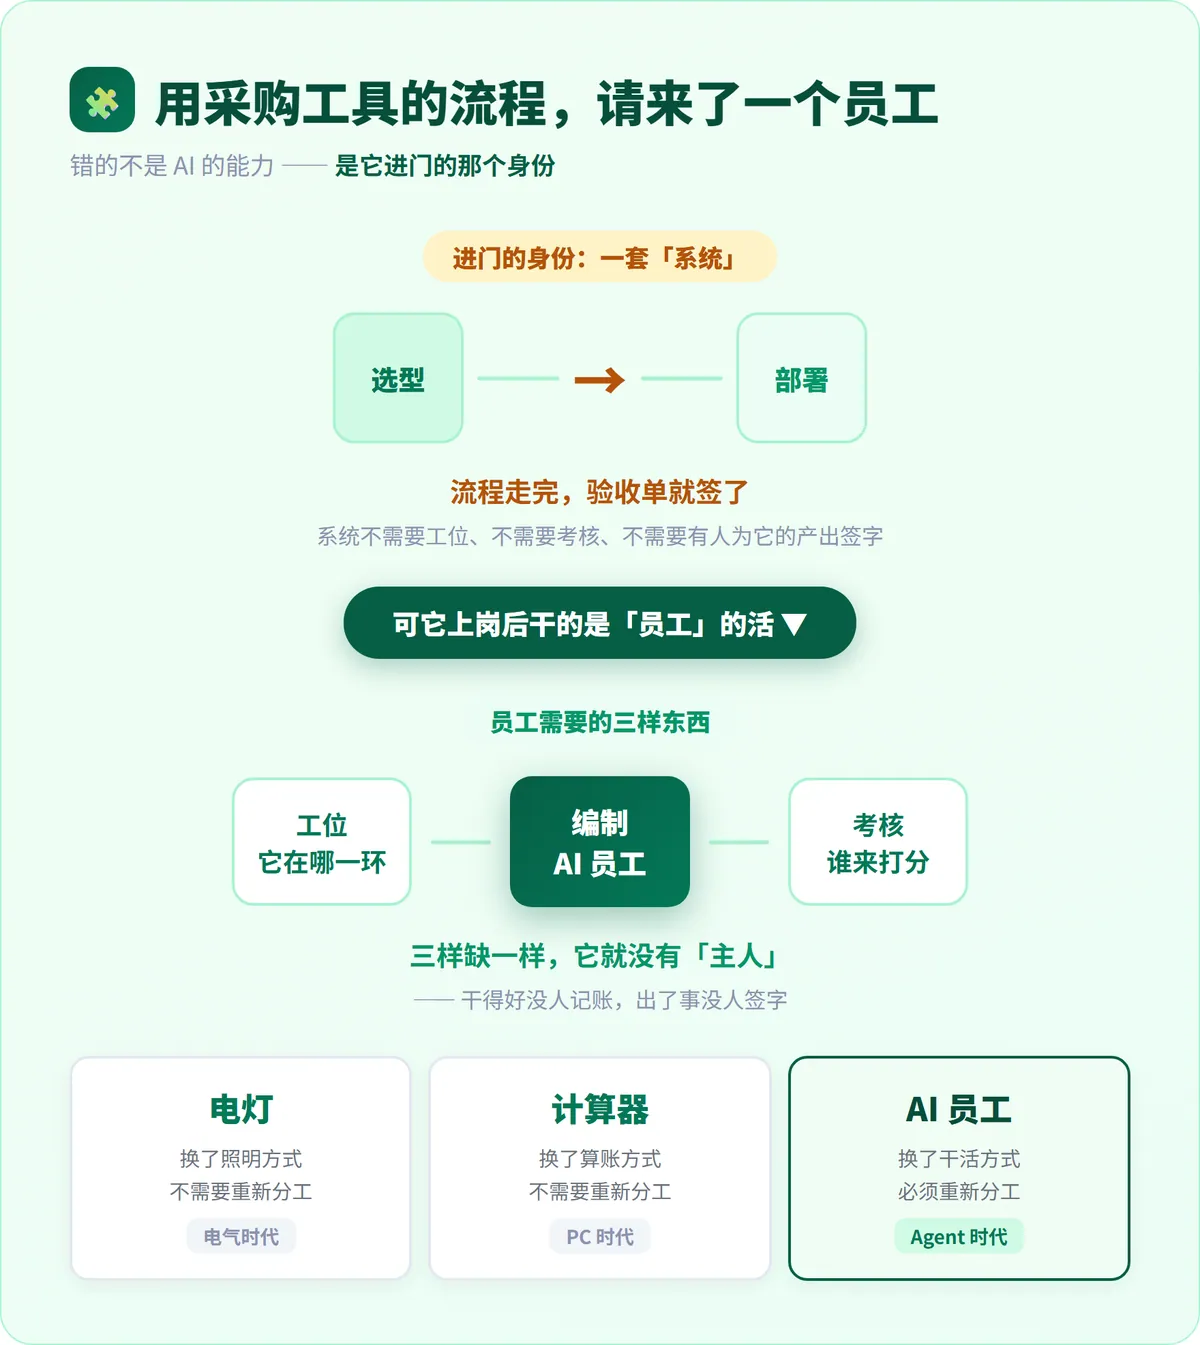
可它真实的工作方式不是工具。电灯替掉蜡烛,不需要重新分工;计算器替掉算盘,也不需要重新分工。AI 替掉的不是某一件具体的事的做法,是「谁来做这件事」。
一旦换成后者,那三个问题就绕不开了:和谁比、归谁管、锅算谁的。
阿里云那份《CIO 之问》里有一句话,我认为是这个领域最诚实的一句:很多企业的 AI 项目停在 PoC,不是因为技术做不出来,是组织本身还没有为 AI 的工作方式做好准备。
翻译一下:不是它不行,是它没有主人。
五、给它上编制:三个归位
如果认同上面这个诊断,动作其实很清楚——把工具的验收流程,换成员工的入职流程。
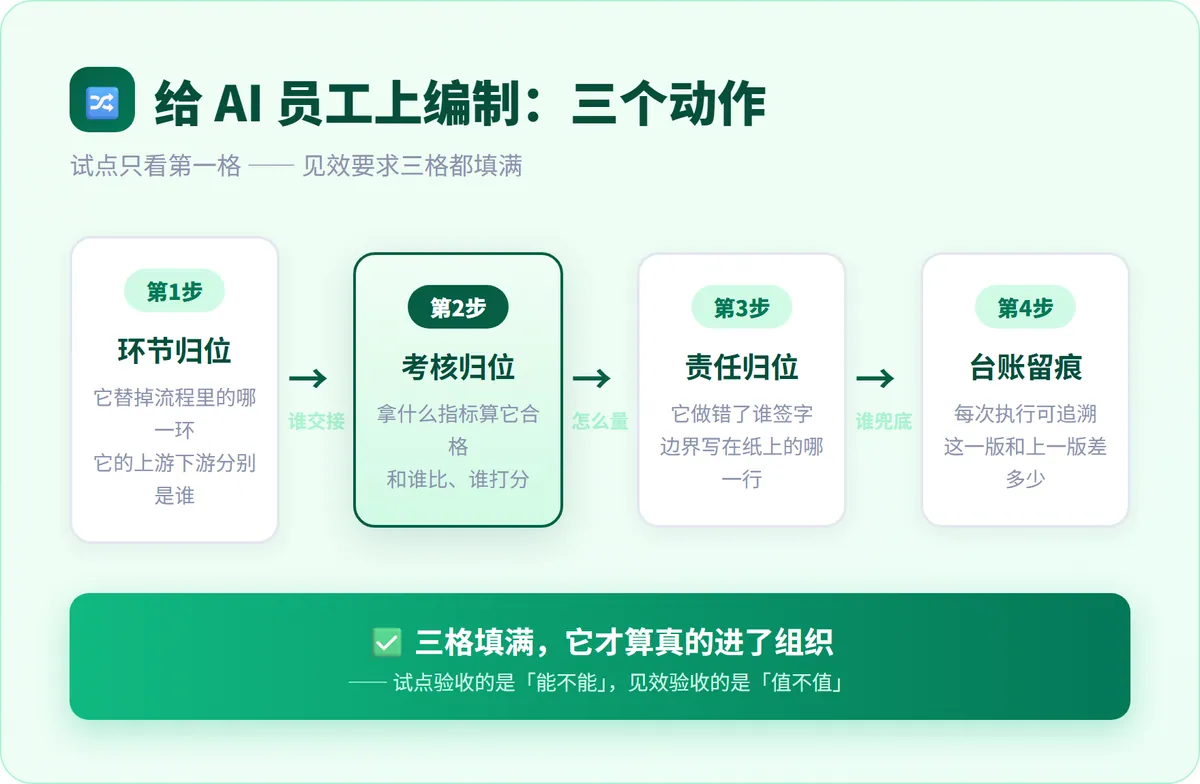
第一,环节归位。说清楚它替掉流程里的哪一环,它的上游是谁、下游是谁。这一步看着简单,但它决定了后面所有考核能不能算清楚。含糊的环节归属,最后一定会变成「这事到底算谁的」。
第二,考核归位。拿什么指标算它合格,和谁比,谁打分。是和专家比,还是和原来这个岗位上的普通员工比?这个选择直接决定它能不能过线。用专家的标准要求它,几乎没有项目能活下来;用「它能干活」来要求它,等于没要求。
第三,责任归位。它做错了谁签字。这一条最容易被跳过,因为它听起来像法务的事,其实是工程的事——边界写在哪一行,决定了它出错的时候会被定性成「事故」还是「已知范围内的偏差」。
我们自己是在第二、三条上吃过教训才补上的。现在的规则是:任何一个「完成」的说法,都必须配一条可验证的证据;复杂任务还要由另一个独立岗位复核一遍。做不到,它不允许说自己完成了。
听起来很重。但对比一下另一种结局:一个跑了三个月、没人说得清好坏的 AI 项目——前面这条路其实是最便宜的。
最后
验收标准这件事,本质上不是流程问题,是认知问题。
你能验收的,只有你看得见的东西。一个组织对「什么叫完成」的定义有多深,决定了它能把 AI 用多深。
试点之所以好用,是因为它把「完成」的定义降到了最低——演示一次,成功了就行。而生产要求你把定义往上抬:抬到过程、抬到账单、抬到责任。
抬不上去的项目,不是死在上线那天,是死在立项那天——那天定下的验收标准,只够验收一个演示。
回到开头那个每天清晨自己起床干活的 AI 岗位。它现在能说自己「完成了」,是因为它有一张档案、一本台账、一道门禁、一个复核人。这些东西没有一样是技术难题——它们全都是「有人为它定了标准」。
我们在给 知名美国净水品牌 净水、谷轮热泵、M77、百世集团这些客户做 AI 系统的时候,验收单上的第一栏从来不是「效果好不好」,而是「这一环归谁、用什么指标算、出错谁签字」。原因很直接:客户不关心你演示得多漂亮,客户关心这套东西明年还在不在跑。
如果你手上正有一个「过了试点但没见效」的项目,这篇文章里至少有一个动作今天就能做:把那个项目的验收标准翻出来,看看它验收的是能力,还是价值。
部分配图由AI生成