• 一组1300+企业的调研数据:Agent上线后卡在哪
• 89%的可观测性 vs 52%的评估:被忽视的落差
• 从"跑起来"到"跑得稳"的三步路径
Agent跑起来了,然后呢
淇经数科 · AI部署与落地观察
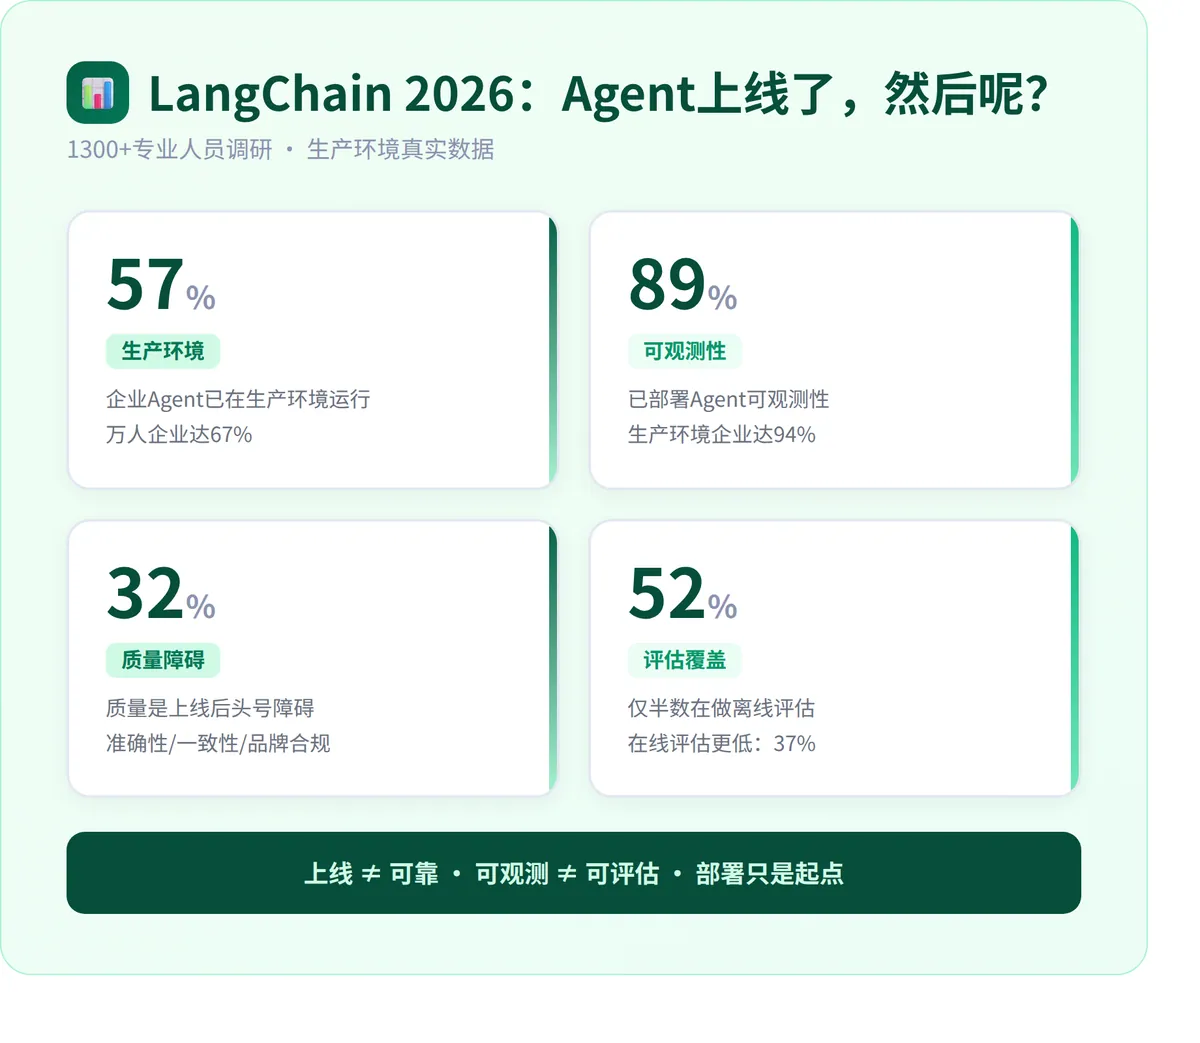
57%
LangChain 2026年6月调研,1300+工程师和决策者中,超过一半说:我们的Agent已经在生产环境里跑了。大企业67%。但32%把质量列为头号障碍——准确度不够、输出不稳定、偶尔胡说八道。
Benchmark跑分≠企业就绪
Benchmark衡量"能不能完成任务",企业部署问的是:能不能在可接受的人工监督下、以可承受的成本、达到需要的可靠性?
READY论文(arXiv 2026年9月)的实验:两个自主准确率只差0.3个百分点的系统(72.8% vs 72.5%),要达到同样76%可靠性,一个需39.2%人工审核,另一个只要29.6%。差了10个百分点的人工成本。ServiceNow AgentArch基准测试也印证:最好的模型,复杂企业任务成功率仅35.3%。
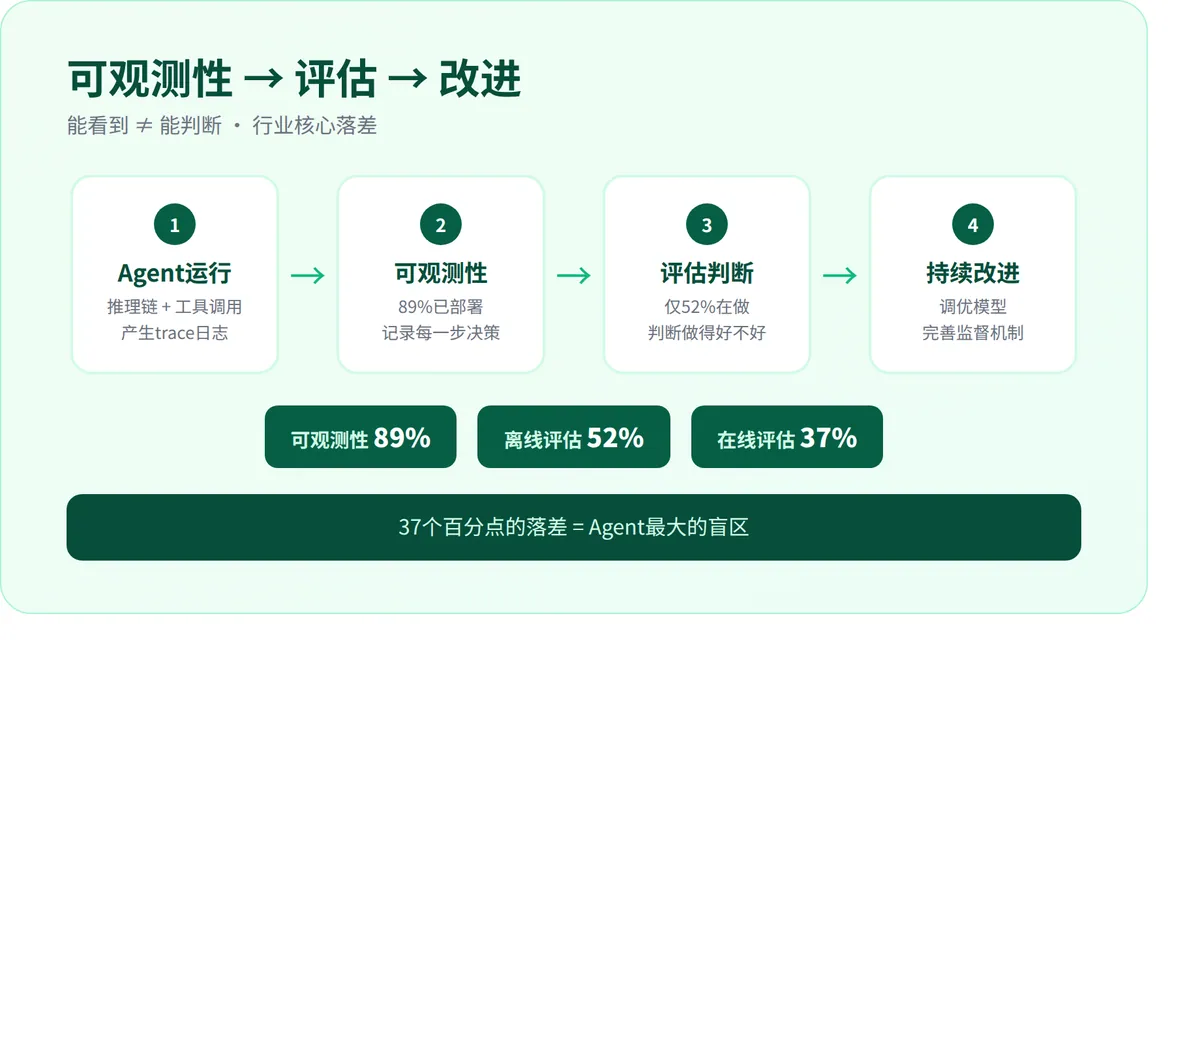
可观测≠可评估:89% vs 52%
89%的企业已部署可观测性(trace日志、工具调用链),生产环境企业达94%。但只有52.4%在做离线评估,线上评估仅37.3%。
可观测性=能看到Agent做了什么。评估=能判断做得好不好。装了行车记录仪不代表做了年检。大量Agent处于"能跑但不知道跑得好不好"的状态。
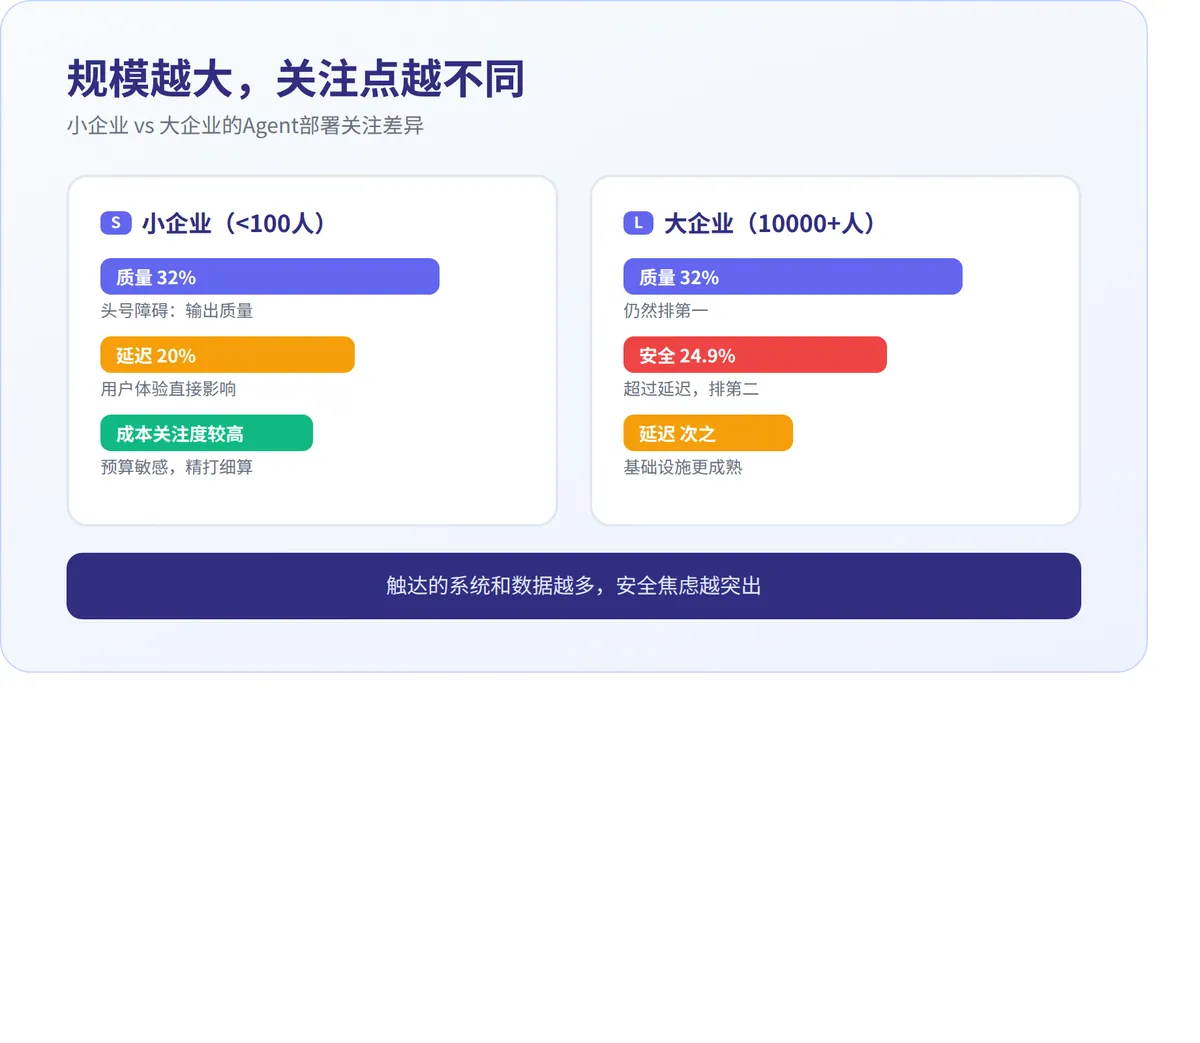
延迟与安全:第二梯队
延迟是第二大障碍(20%)——Agent面向用户时,响应时间直接影响体验。成本关注度反而下降了,企业从"花多少钱"转向"花的钱值不值"。但万人以上大企业里,安全浮现为第二大关注(24.9%)——Agent触达的系统和数据越多,安全焦虑越突出。
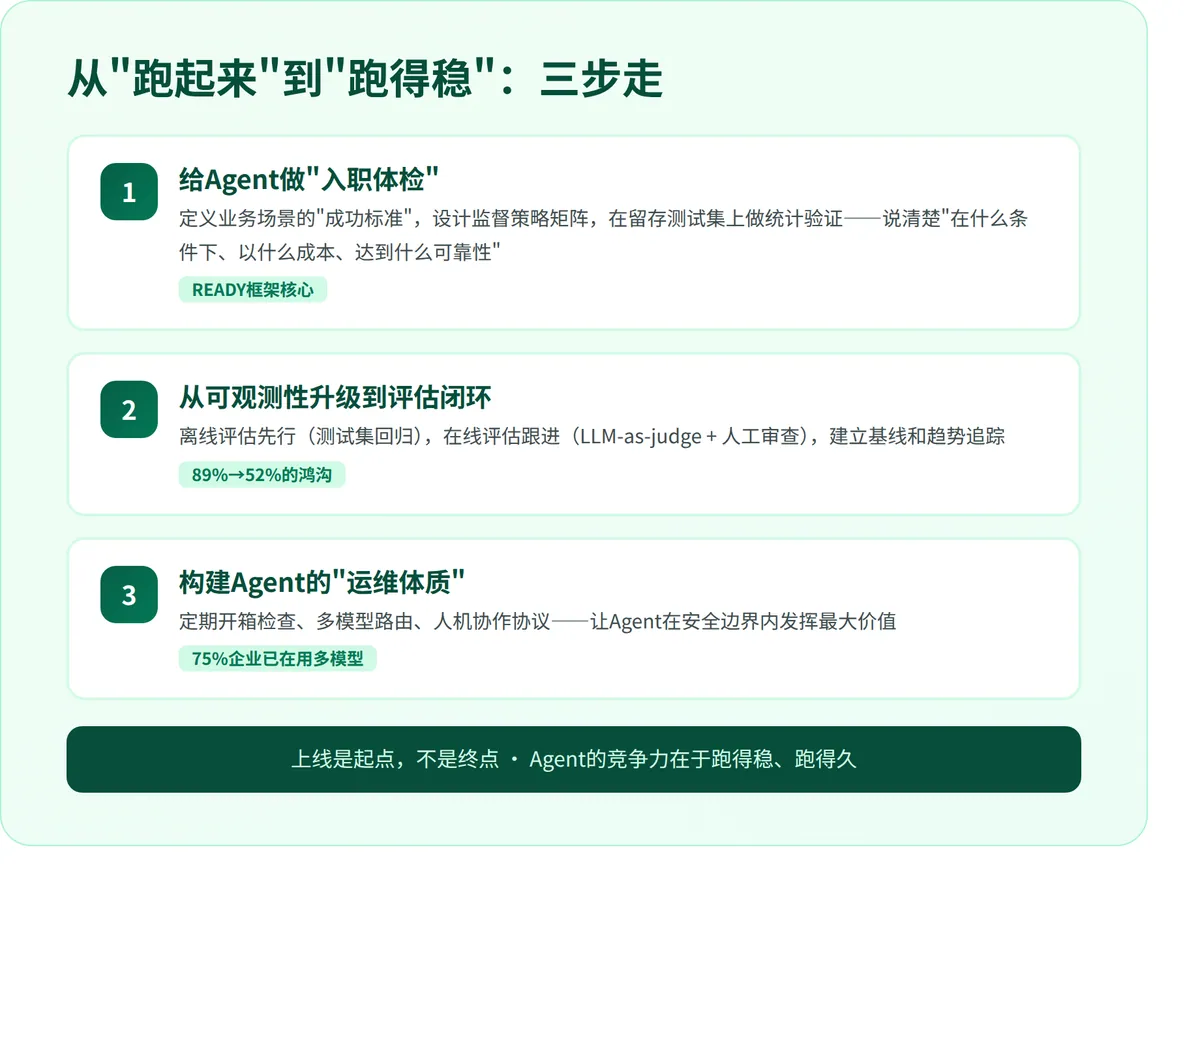
三步走:从"跑起来"到"跑得稳"
① 给Agent做"入职体检"。定义业务场景的"成功标准",设计监督策略矩阵(低风险自主跑、高风险必须审核),在留存测试集上做统计验证。
② 从可观测性升级到评估闭环。离线评估先行(测试集回归),在线评估跟进(LLM-as-judge + 人工审查),建立基线和趋势。
③ 构建Agent"运维体质"。定期review异常case、多模型路由(75%企业已在用)、建立人机协作协议。
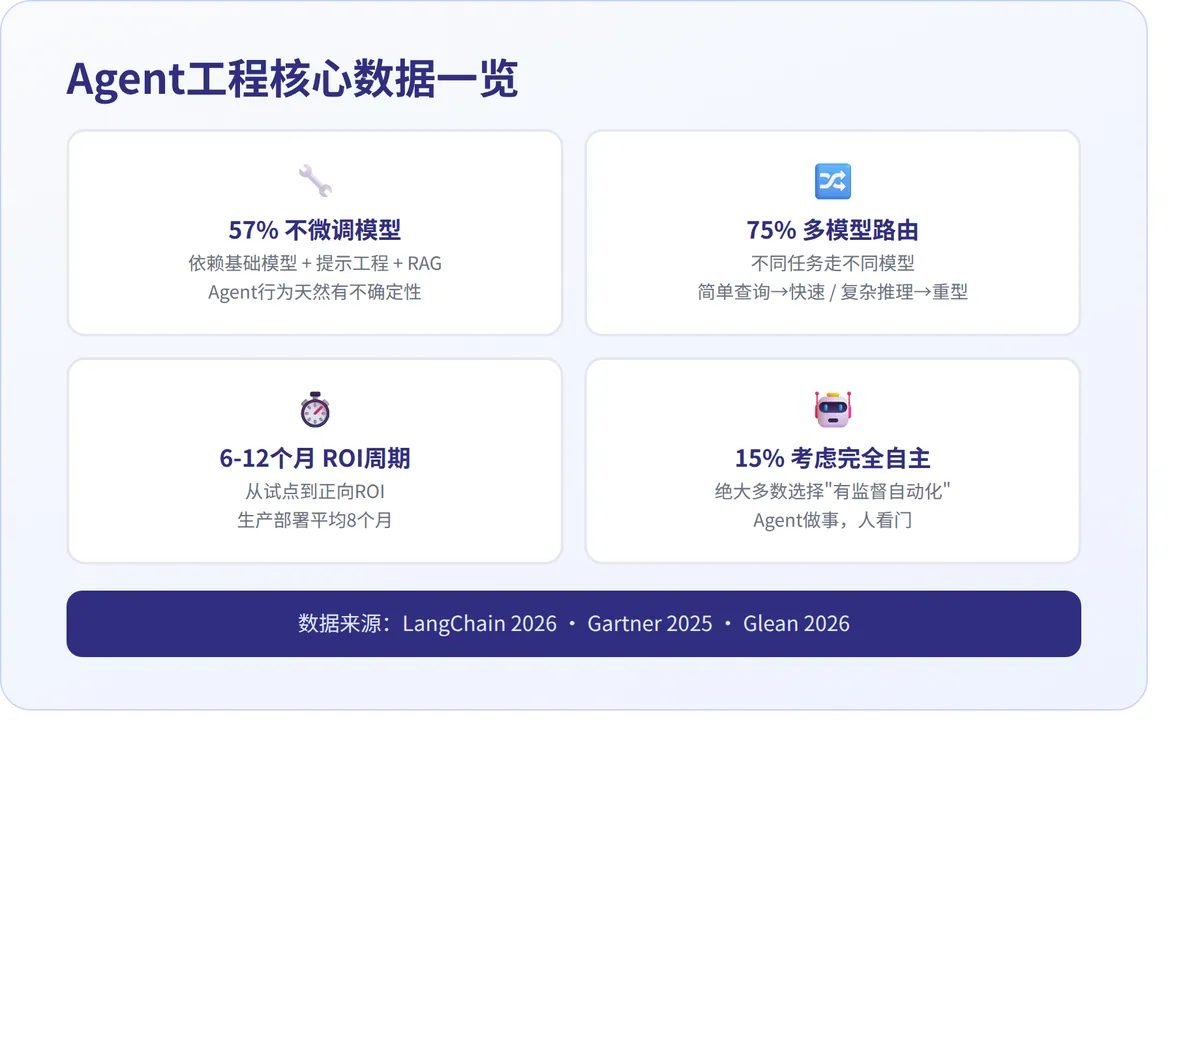
Agent工程:新学科正在形成
LangChain提出"Agent Engineering"——将大模型转化为可靠系统的迭代过程。Gartner调研:75%企业部署AI Agent,但仅15%考虑完全自主。Glean分析:从试点到正向ROI平均6-12个月。
在知名美国净水品牌、谷轮、RUUD等品牌项目中,我们体会到:AI系统的价值在持续运维中逐步释放。谷轮AI客服上线首月自动解决率62%,三个月后通过持续优化达79%——17个百分点的提升不是新模型带来的,是运维迭代带来的。RUUD智能家居Agent推荐准确率从58%提升到81%,靠的是评估指标+每周review+知识库完善。我们把这套方法叫FDE(前沿部署工程)。
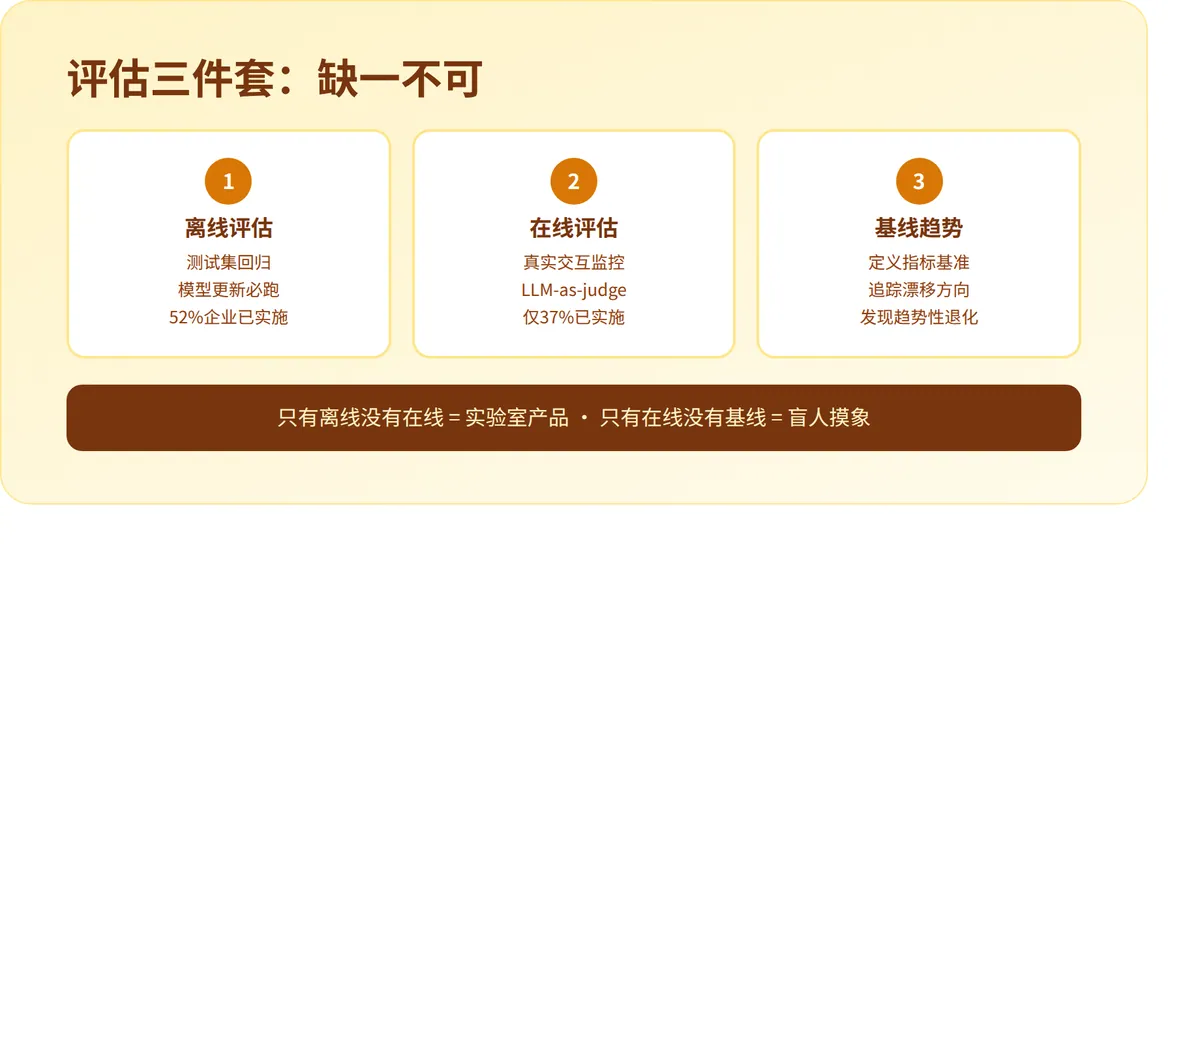
回到最初的问题
Agent跑起来了。然后呢?Agent的竞争力不在于能不能跑,而在于跑得稳不稳、跑得久不久。上线是起点,不是终点。
问自己三个问题:
① 你的Agent有评估机制吗?
② 你知道它的质量趋势吗?
③ 你有人机协作协议吗?
数据来源:LangChain "State of Agent Engineering" Jun 2026 · Chatrath et al. "READY" arXiv:2609.02095 Sep 2026 · ServiceNow AgentArch 2025 · Gartner Sep 2025 · Glean 2026