AI Agent 为什么活不过三天?
导读卡
**导读**:阅读本文你将获得:
- 看懂 AI Agent 从「Demo 很惊艳」到「上线就翻车」的三大死因
- 一份生产环境 AI Agent 可靠性诊断清单(3 个维度 9 项检查)
- 一套「Agent 健康三支柱」的工程框架,拿来就能用
正文
你的 AI Agent 在演示环节跑得飞快,回答精准,决策果断。但上线三天后,它开始胡言乱语;一周后,它忘了自己是谁;两周后,你的运维同事问你:「那个 Agent 是不是已经挂了?」
这不是段子。LangChain 2026 年《Agent 工程现状报告》调查了 1300 多名从业者,57% 的组织已经把 AI Agent 部署到了生产环境——但质量,连续两年蝉联最大障碍,32% 的人把票投给了它。另一组数据更扎眼:88% 的企业级 Agent 试点项目,Demo 阶段完美通过,到了真实业务流程里就全线崩溃(Fiddler,2026)。
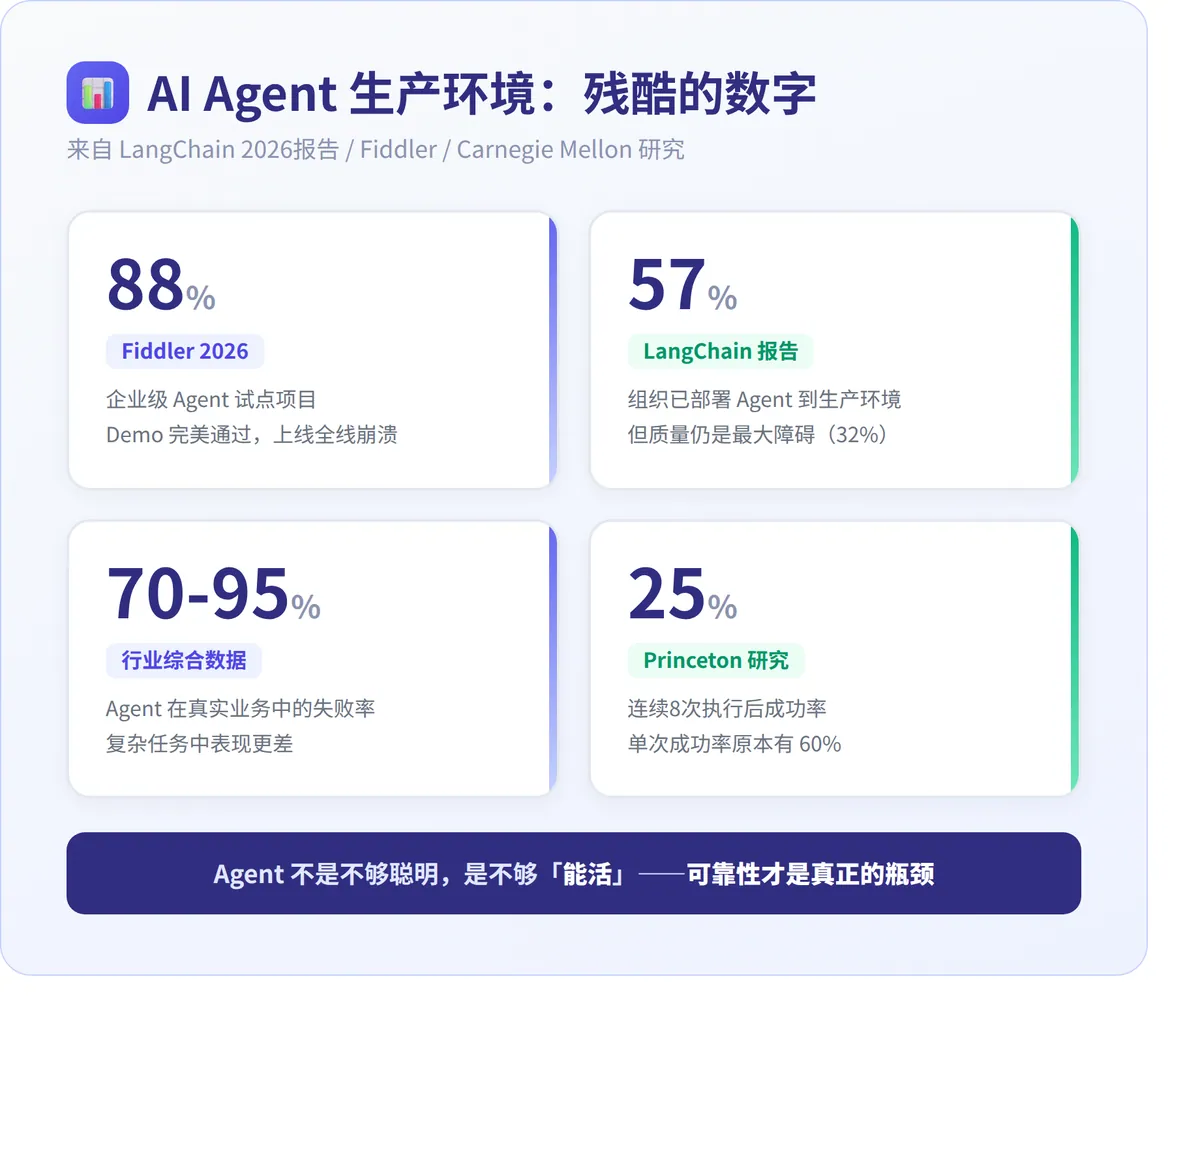
Agent 不是不够聪明,而是不够「能活」。我们团队用 Hermes Agent 跑了五个生产级岗位——小助理、小开、小淇、小营、小马——每个都有独立的模型、网关、记忆库和定时任务,已经连续运行数月。在这个过程中,我们踩过几乎所有能踩的坑。今天拆开讲三个最致命的。
第一个坑:记忆塌方——Agent 上线三天就「失忆」
Agent 的记忆不是永久存储,而是一块有限的笔记本。上下文窗口(context window)填满后,最前面的内容会被挤出去。挤掉的不是无关紧要的闲聊——而是它自己的行为规则。
LangChain 报告里,10000 人以上规模的企业把「幻觉」和「输出不一致」列为头号质量杀手。Princeton 大学评估了 14 种 Agent 框架,发现经过 18 个月的能力提升,可靠性只进步了一点点。原因很朴素:模型能力是线性增长的,但记忆衰退是非线性的。
我们的应对方案叫「记忆日活治理」。核心逻辑:不是给 Agent 更大的笔记本(加长上下文窗口治标不治本),而是教它怎么记笔记——什么该记、什么该忘、什么该压缩。
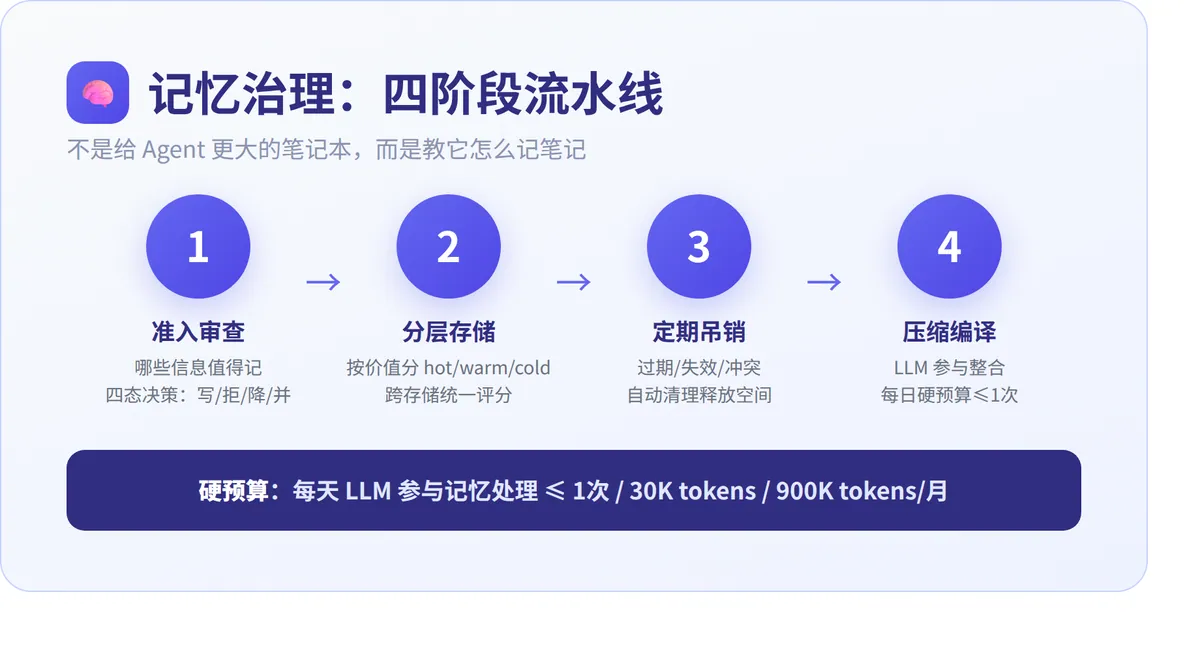
实测数据:治理前,五个岗位每天产生约 45000 字符的记忆增长;治理后,压制到 20000 字符以内,同时关键信息召回率反而提升了。这不是魔法,是工程——把记忆分成「准入审查→分层存储→定期吊销→压缩编译」四个阶段,每个阶段有明确的规则和预算。
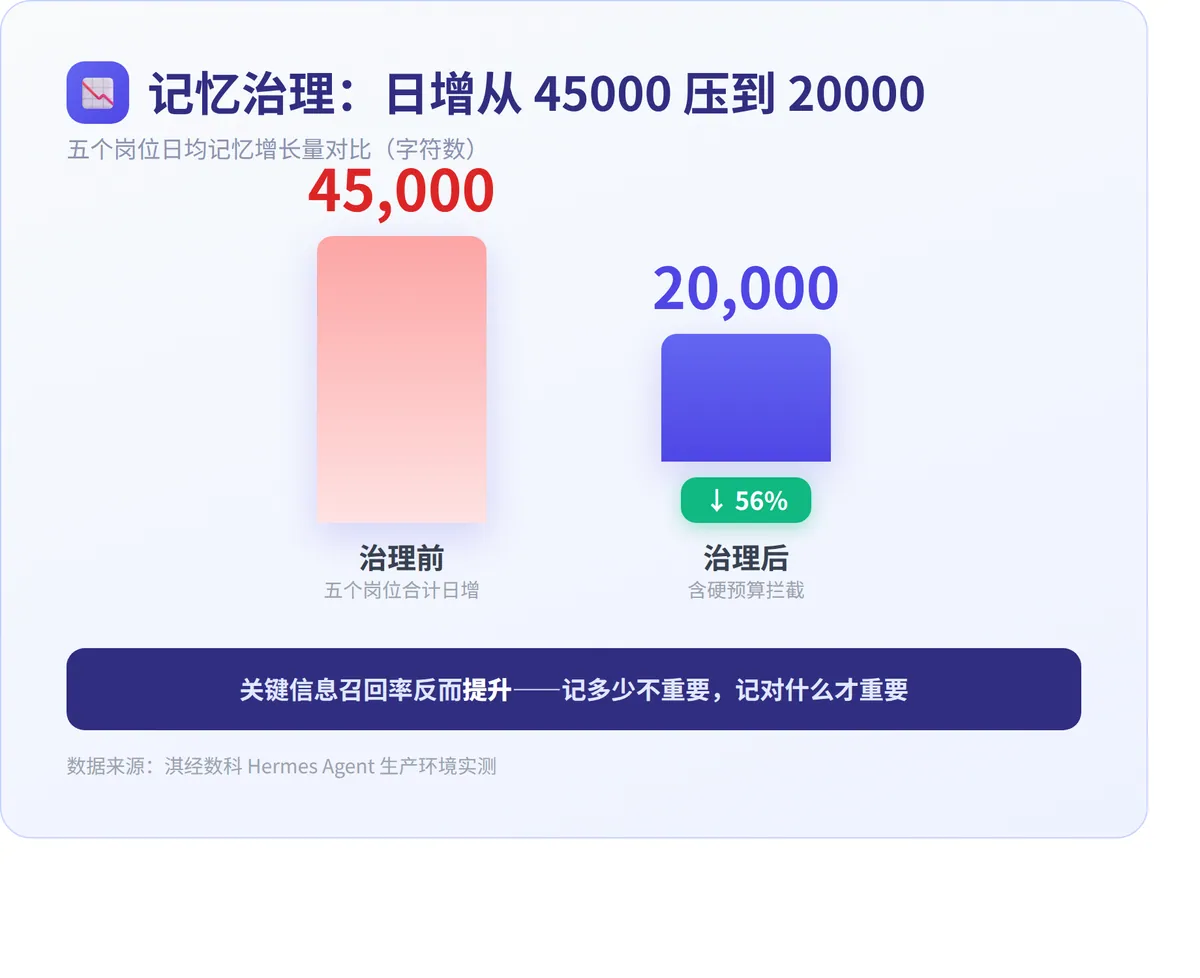
记忆治理的下一步是建立「硬预算」:每天允许 LLM 参与记忆处理的次数不超过一次,每次不超过 3 万 tokens。预算用完就停,不管任务多紧急。听起来不近人情,但这是防止 Agent 无限膨胀的唯一手段。
第二个坑:依赖链断裂——一个组件倒下,整个系统瘫痪
AI Agent 不是独立运行的,它依赖一整条链路:模型 API、插件系统、工具调用、网关服务、定时任务……任何一个环节断掉,Agent 就像断了电的机器人,僵在原地。
我们的真实案例:五个岗位的 Agent 共用一个网关进程。某天凌晨,一个插件在持锁期间调用了数据库——SQLite 默认的锁等待机制导致整个进程卡死 117 秒。一个 Agent 卡死,其他四个也被拖垮。五个岗位同时下线,直到看门狗进程检测到异常并重启网关。
这个问题催生了两个工程对策:
对策一:网关进程内不能重启。 这是铁律。Hermes 的 lifecycle_guard 会拦截一切进程内的 restart 尝试——不管是你自己重启还是第三方插件触发。正确做法是写一个信号文件,外部看门狗每 20 秒扫描一次,发现信号就干净地重启整个进程。这保证了重启是「外部介入」而非「内循环死锁」。
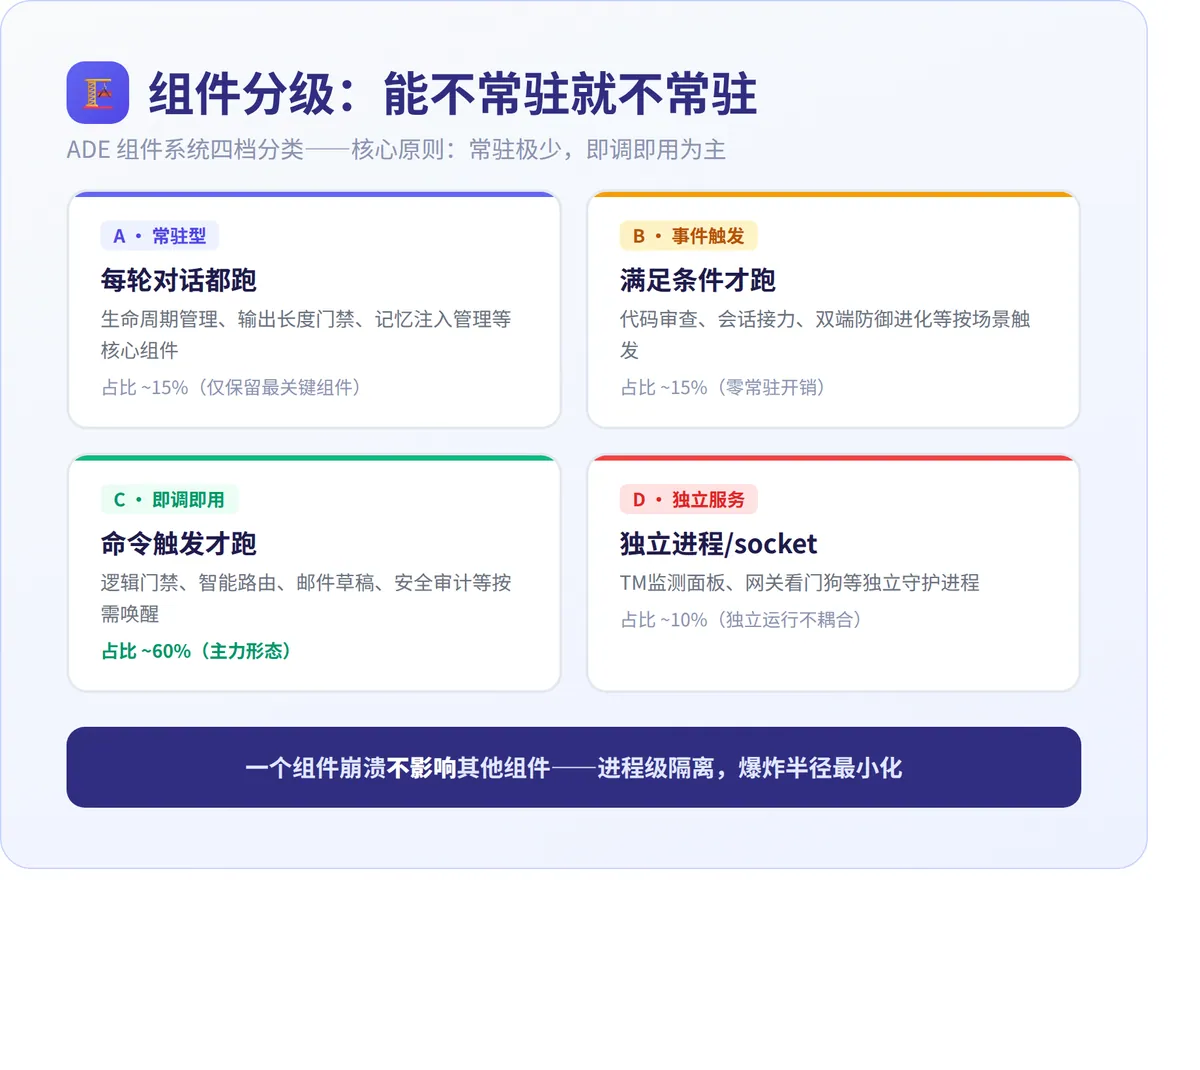
对策二:组件生命周期分级。 我们的 ADE 组件系统把所有组件分成四档:常驻型(每轮对话都跑)、事件触发型(满足条件才跑)、即调即用型(命令触发才跑)、独立服务型。核心原则是:能不常驻就不常驻。即调即用型占了我们组件总数的 60% 以上,它们平时零开销,只在需要时才被唤醒。一个插件崩溃不会影响其他插件,因为它们之间没有进程级耦合。
Carnegie Mellon 的研究显示,AI Agent 在常见办公任务中的失败率约 70%。我们通过组件分级和网关看门禁,把单点故障的影响范围从「整个系统瘫痪」缩小到「单个功能暂时不可用」。不是消灭故障,而是限制故障的爆炸半径。
第三个坑:静默死亡——你的 Agent 可能已经「死了」,你还不知道
最危险的不是 Agent 报错——报错说明它还活着。最危险的是它安静地死了。
凌晨三点的定时任务失败了,没有告警,没有重试,没有人知道。直到第二天早上,用户发现「为什么今天的报告没生成?」「为什么昨天的推送没有发?」——才发现 Agent 已经挂了一整夜。
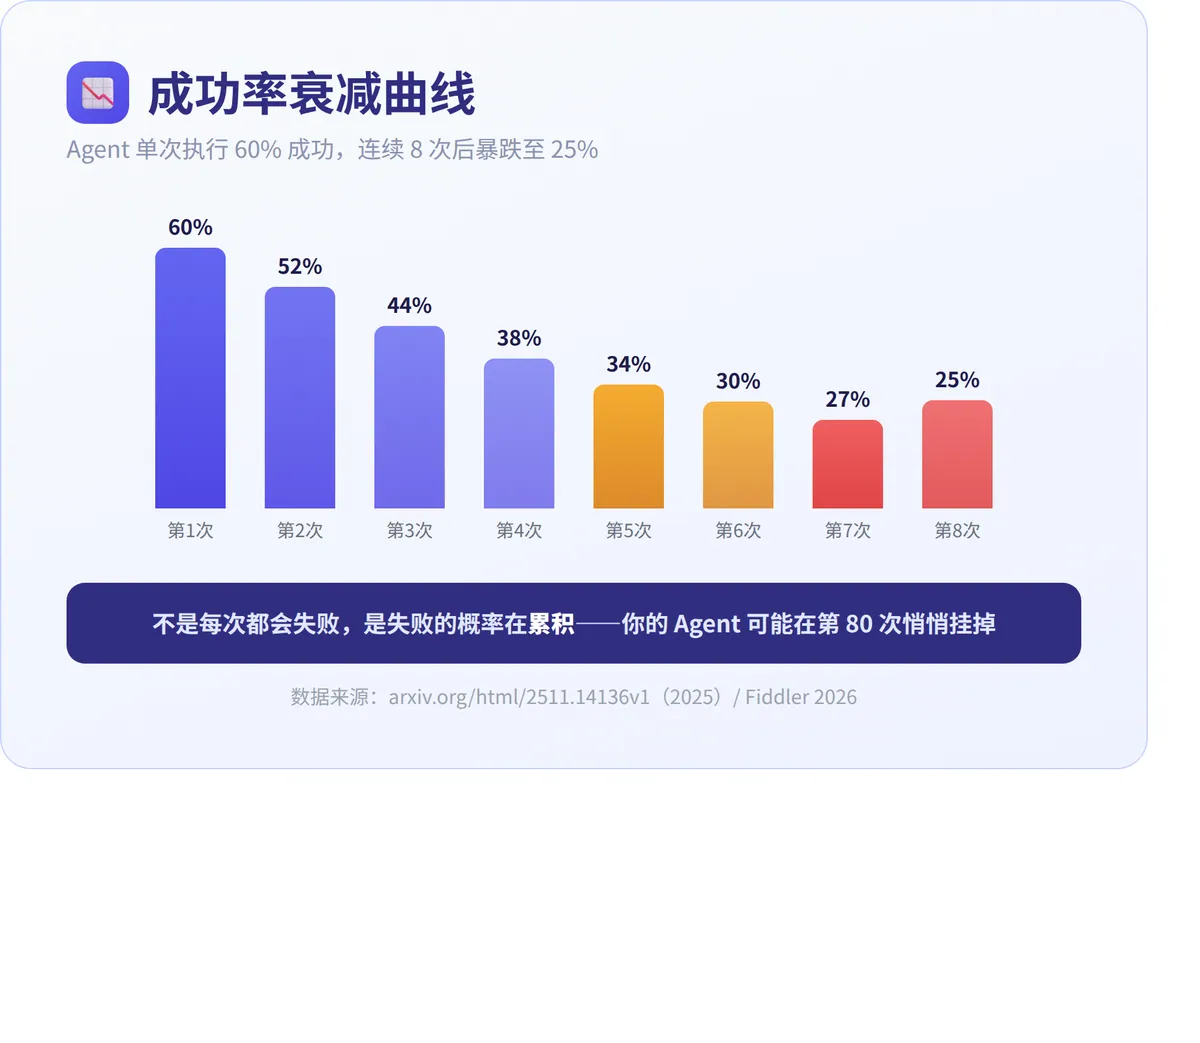
Fiddler 的报告揭示了一个细节:Agent 单次执行成功率 60%,但连续 8 次执行后,成功率暴跌到 25%。不是每次都会失败,而是失败的概率在累积。你的 Agent 可能前 79 次都跑成功了,第 80 次悄悄挂掉——而你在第 81 次才注意到。
我们的「系统看门狗」机制是这样工作的:每天 22:00,一个独立的看门任务会对整个系统做一次全面体检——六个模块加上两个扩展模块,正常时输出不超过 10 行,异常时展开详细报告。发现异常立即报警,不等第二天。
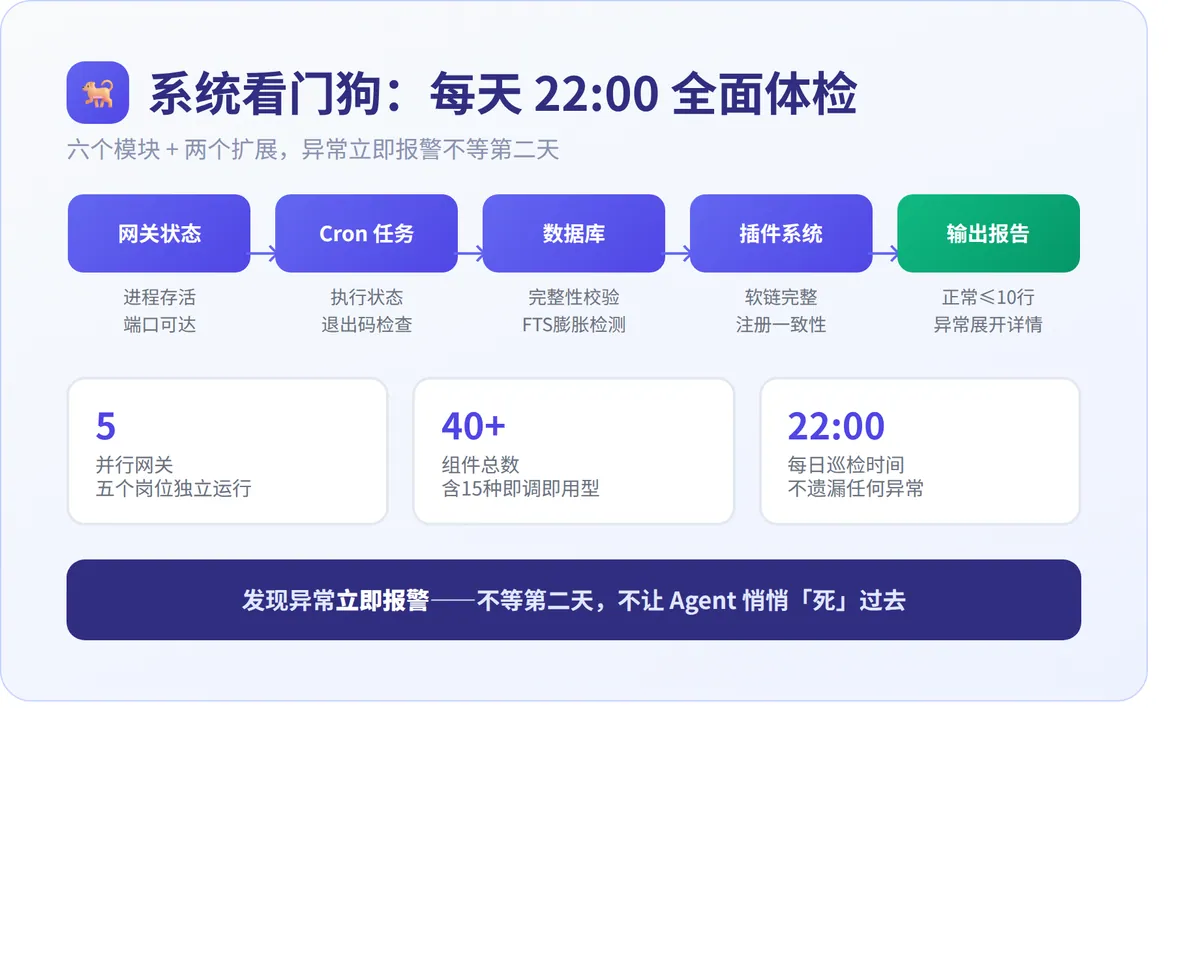
但看门狗只是最后一道防线。真正的防线是让 Agent 具备「自我感知」能力——它能知道自己的记忆快满了、自己的某个工具调不通了、自己今天的工作量是否超标。这需要三个支柱:实时监控(知道出了什么问题)、内存治理(防止记忆溢出)、组件生命周期管理(防止一个坏组件拖垮整个系统)。
靠谱的 Agent 不是模型强,是工程强
LangChain 的报告里有一组数据特别有意思:89% 的组织已经为 Agent 部署了可观测性工具,但只有 52% 部署了评估工具。也就是说,很多人能看到 Agent 出了问题,但不知道怎么判断它「够不够好」。
这不是技术问题,是工程思维问题。
模型能力是上限,工程能力决定你能不能跑到那个上限。五个岗位、四十多个组件、一套记忆治理机制、一个看门狗系统——这些不是炫技,是让 Agent 在生产环境里活下去的基础设施。
回到开头那个场景:你的 Agent 上线三天就翻车。不是因为它不够聪明,而是因为它缺少一个让它活下去的工程体系。模型可以换,但工程体系必须建。
行动号召
也欢迎在评论区聊聊:你们的 AI Agent 在生产环境里遇到过哪些「翻车」经历?
扫描下方二维码,获取「Agent 可靠性工程」工具包
记忆治理参数模板 · 组件分级清单 · 看门狗配置指南
— 全文完 —
本文同步自淇经数科公众号(2026-09-20-AI-Agent活不过三天-AI),文中数据与案例以真实交付为准。
想知道 AI 现在怎么介绍你的品牌?免费获取《品牌 AI 可见度诊断报告》:AI 说了什么、说错在哪、同行占了多少位置。