📖 导读:阅读本文你将获得:
- 一套诊断 Token 浪费的三问框架,立刻能用
- 为什么 50% 的 Token 可能正在被白白烧掉
- 从 Agent 框架、模型路由到 KV 缓存的省钱路径
- 一个判断「你的 Agent 是否在赔钱」的简易公式
你的 AI Agent 每天烧掉多少 Token?
你大概率不知道。但这个数字可能比你想象的大很多。
我们服务过的客户里,有一家做净水设备的500强企业(3M),他们的技术团队在部署 AI Agent 后第一周,Token 账单就超出了预期的 5 倍。另一家高端暖通品牌(谷轮),在 Agent 初期测试阶段,工程师每人每周的 Token 消耗成本就超过了 2000 元。还有一家智能家居企业(思帕),直接把 AI Agent 的 Token 预算从年度 IT 预算里单独拎出来做管控。
50% 的 Token,正在被浪费
2026 年,AI Agent 从实验室走进了办公室。但走进办公室的那一刻,一个新的成本黑洞也跟着来了。
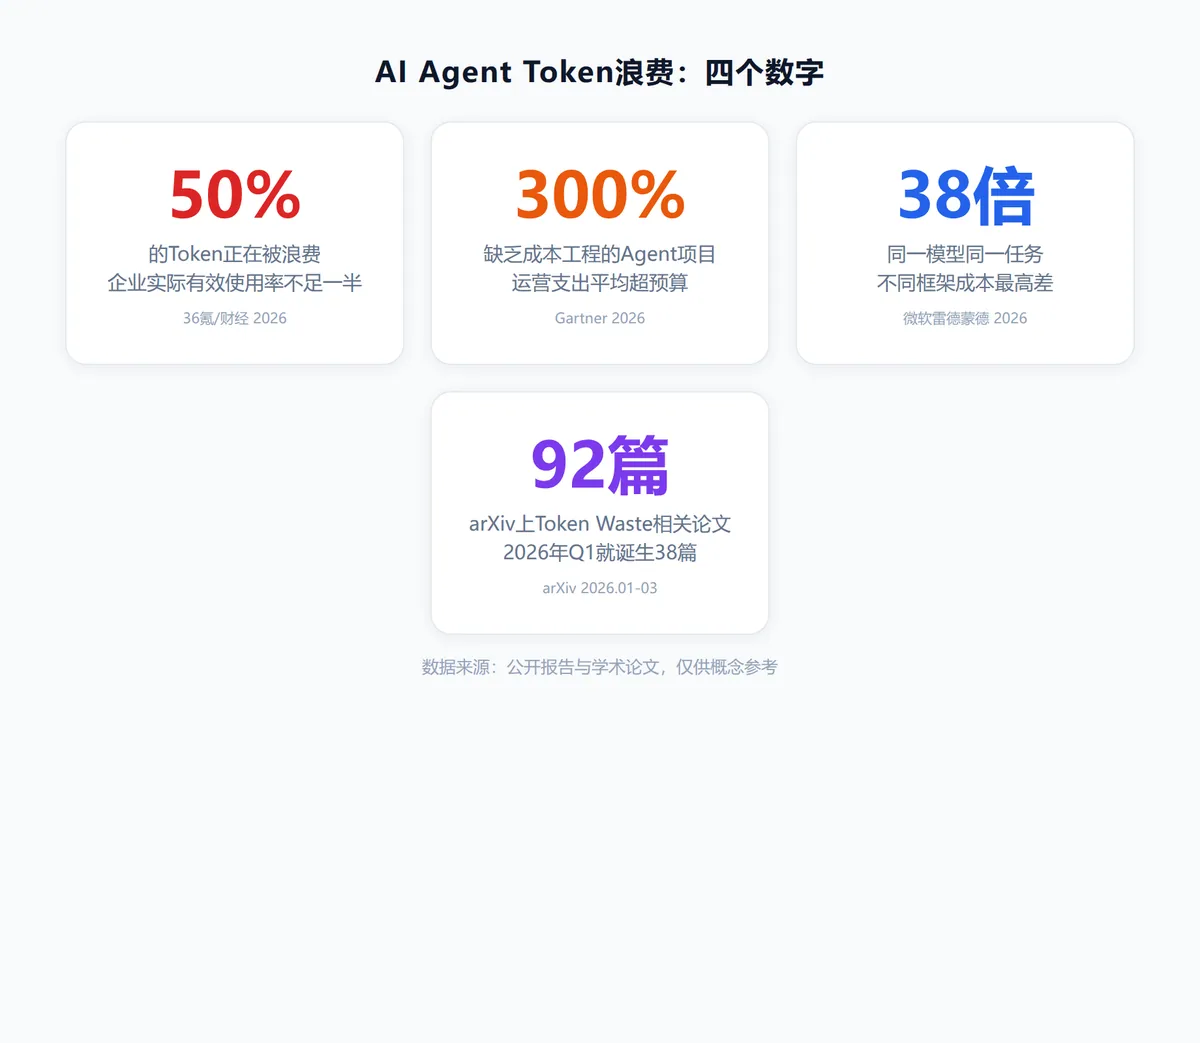
今年一季度,GitHub 上关于「Token Waste」的技术讨论超过了 4000 条。arXiv 上相关的学术论文也激增到 92 篇。一个曾经只属于学术界的概念,突然成了企业 CTO 茶歇时最常聊的话题。
一句话说清:Agent 每执行一轮任务,不是消耗一点点 Token,而是消耗很多。而且其中很大一部分,是浪费的。
一个真实案例:Lumigo 的联合创始人 Nicola Alessi,用 Claude Sonnet 4.6 在一个 200+ 文件的生产项目里跑 Agent。他发现,每次提问 Agent 都会发起 23 次工具调用——先扫全部文件,再按语言过滤,然后逐个打开读取,循环 20 轮之后才开始处理问题。每轮对话平均消耗 18 万个 Token,真正和问题相关的,不超过 5 万。
浪费率 72%。
这不是个例。36 氪报道的一家万人互联网公司,工程师日常使用的 Token 有 30%-50% 因 Agent 工程不完善被浪费。
账单为什么膨胀
要理解 Token 为什么被浪费,先要理解 Agent 是怎么花 Token 的。
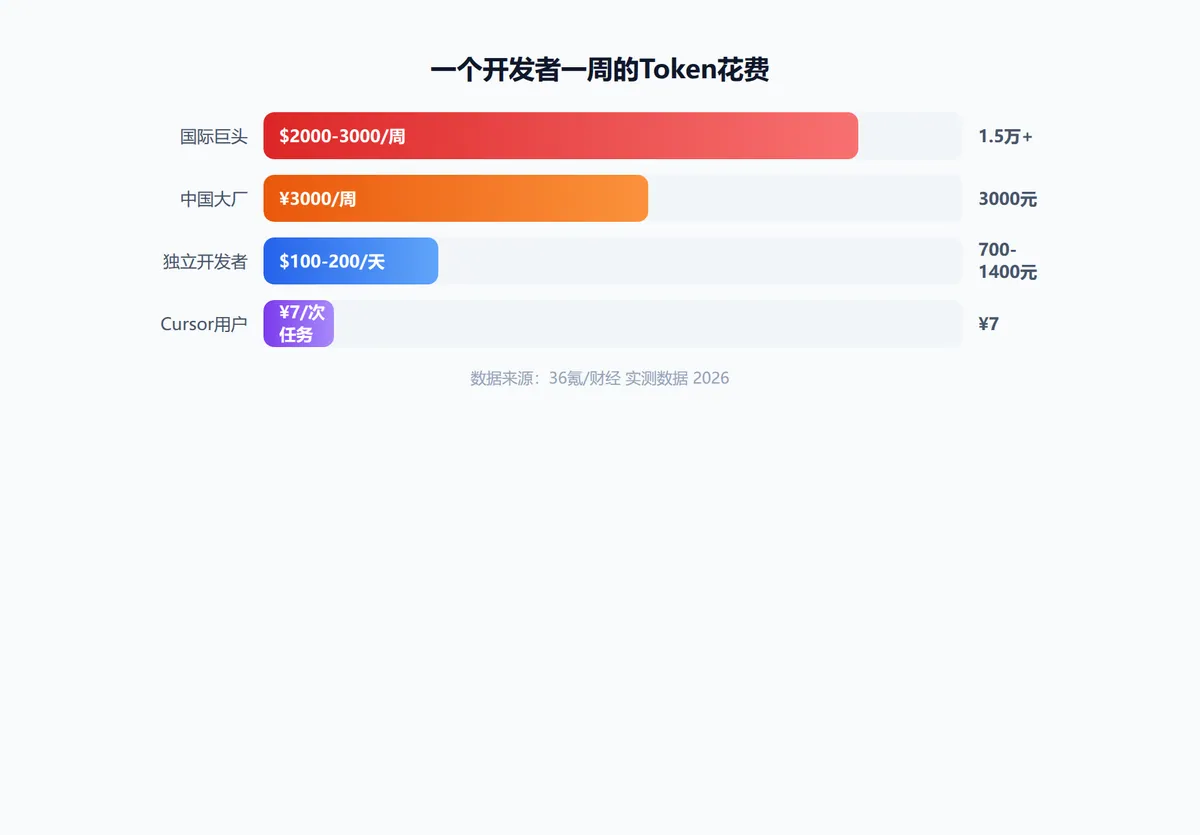
传统 AI 对话是「一问一答」——你说一句,它回一句,Token 消耗线性增长。Agent 不一样。Agent 是一个会主动思考、调用工具、记录状态的「自主执行者」。一次用户对话可能只消耗几千 Token,但一次完整任务,可能消耗数万甚至数十万 Token。
这意味着什么?意味着你的 AI 账单不再是固定月费,而是按「任务复杂度」动态计费。
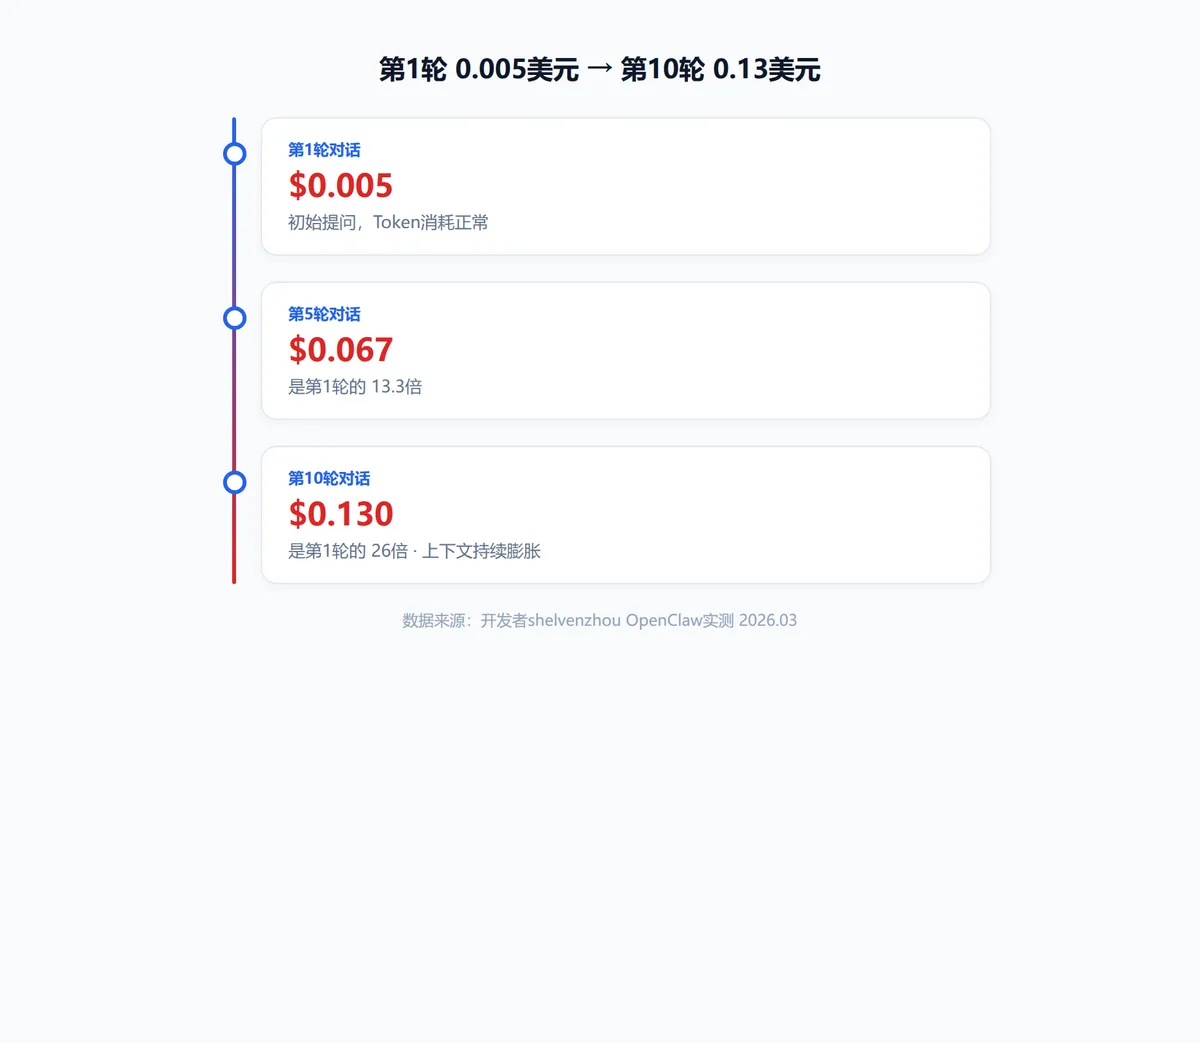
一位开发者的实测数据:
第 1 轮对话:0.005 美元。第 5 轮:0.0665 美元——是第 1 轮的 13 倍。第 10 轮:0.13 美元——是第 1 轮的 26 倍。
Token 消耗不是线性增长,是指数级增长。每多一轮对话,成本就多翻一倍。
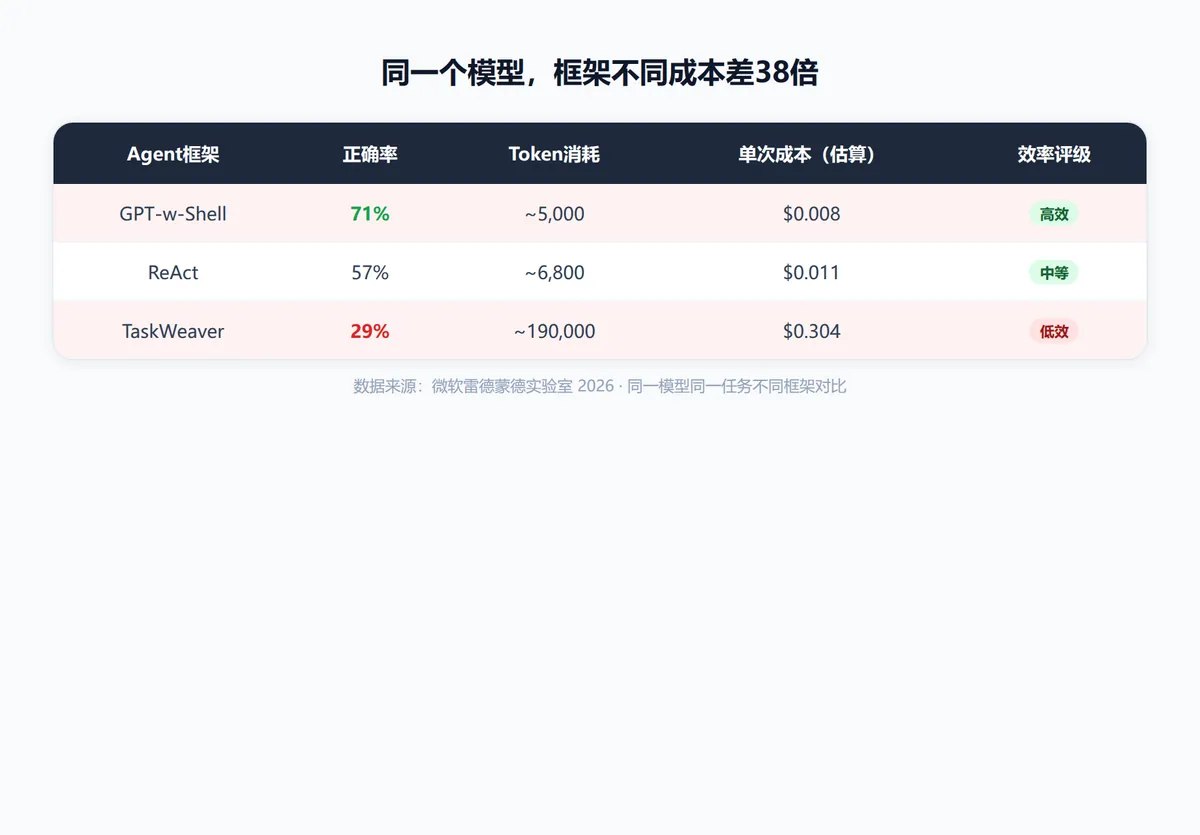
更麻烦的是,不同 Agent 框架的效率差距巨大。微软雷德蒙德实验室做过一个实验:让不同 Agent 框架去定位同一个云基础设施故障,用的是同一个模型。结果:最好的 GPT-w-Shell 在 71% 正确率下只消耗约 5000 个 Token;TaskWeaver 正确率仅 29%,Token 消耗却高达 19 万。
同一个模型,同一个任务,框架不同,成本差 38 倍。
Token 为什么被浪费
浪费不是因为模型不行,而是 Agent 的「缰绳」没套好。
腾讯集团高级执行副总裁汤道生把这个问题叫做「Harness」——缰绳。他说:驯服一匹野马,需要一副趁手的缰绳,和一个知道目的地的骑手。
Token 浪费的三大根因:
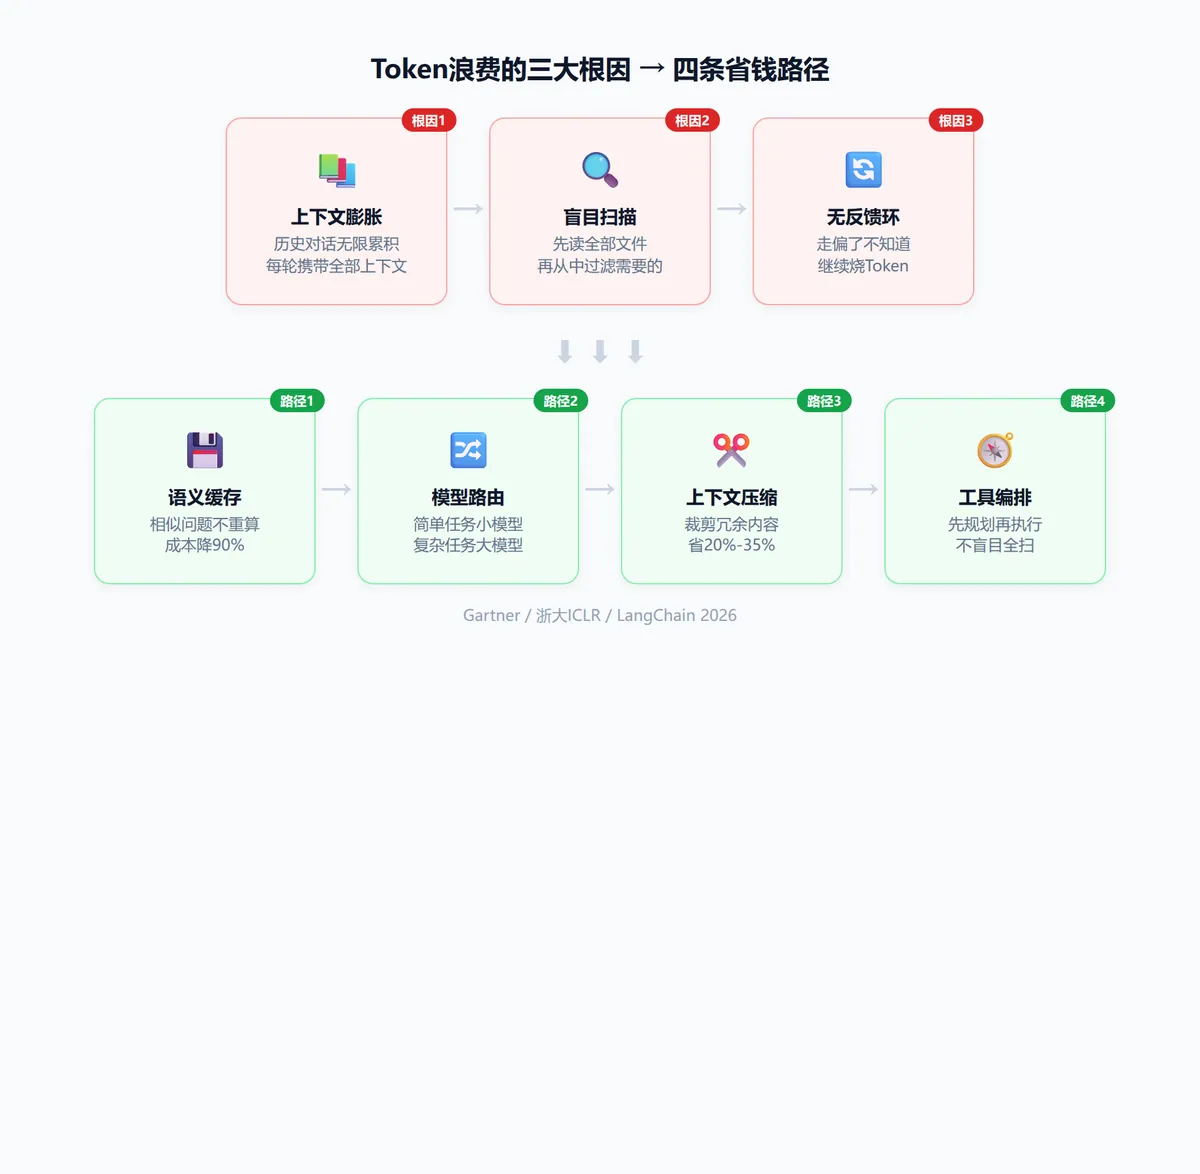
第一,上下文无限膨胀。Agent 执行任务时,历史对话、中间结果、工具返回的数据会不断累积。每一轮新请求都要携带完整的上下文,计算量呈指数增长。但其中可能 30%-60% 的内容已经和当前任务无关。
第二,工具调用不智能。很多 Agent 采用「先全扫、再过滤」的策略——把所有文件都读一遍,再从中找需要的。这就像你去图书馆查一个概念,不是先查目录,而是把整个图书馆的书都翻一遍。
第三,缺少反馈环。Agent 用完一轮 Token,不管结果好不好,继续用下一轮。没有「停下来想想是不是走偏了」的机制。一篇浙江大学的 ICLR 论文证明:加一个「监督 Agent」实时识别错误和冗余,可以在保持任务成功率的同时,把 Token 消耗降低 30%。
省钱的四条路
问题清楚了,怎么解决?
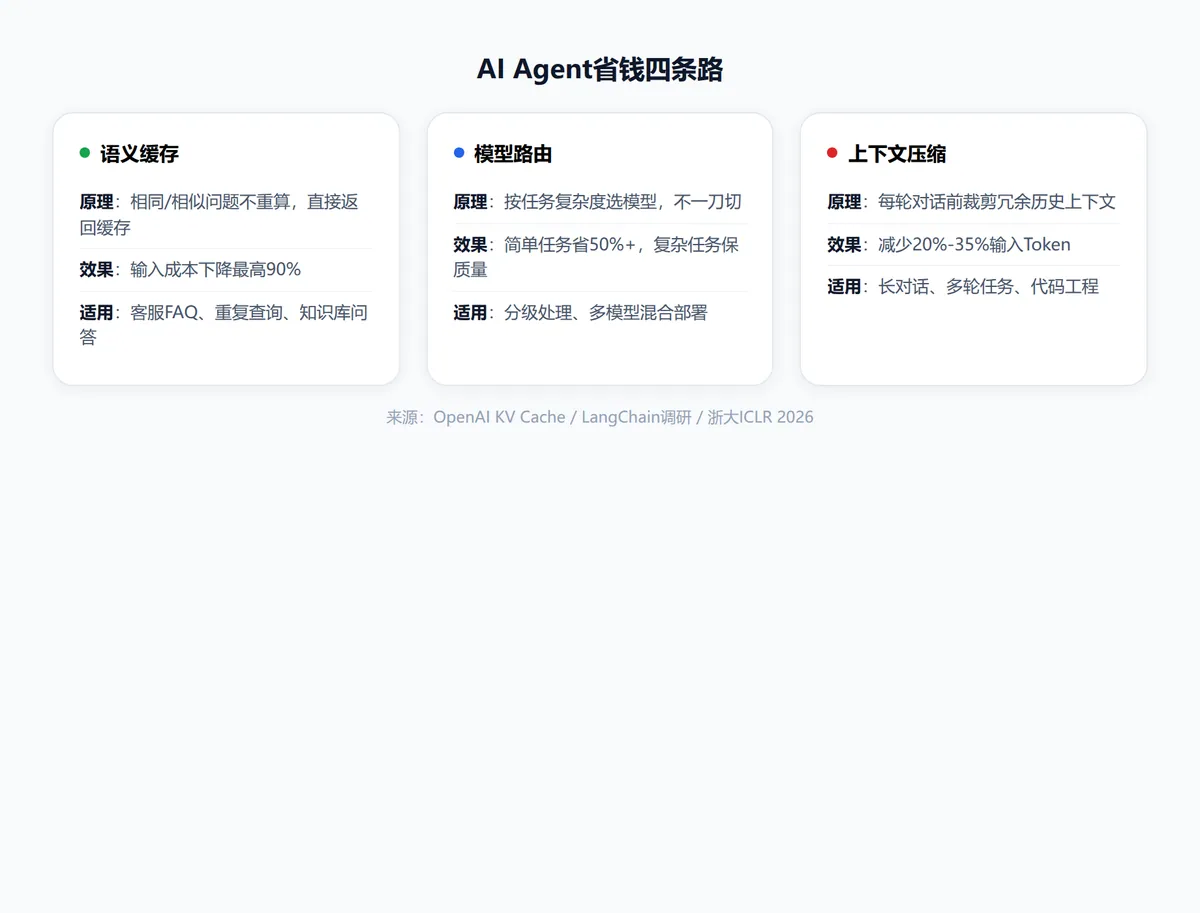
第一,语义缓存。类似问题问过一遍,下次再问时直接返回缓存结果,不重新调用模型。OpenAI 的数据显示,KV 缓存可以让输入 Token 成本下降最高 90%。
第二,模型路由。不是所有任务都需要最强模型。简单任务用小模型,复杂任务才上大模型。LangChain 的调查显示,57% 的企业已经在用多模型策略。
第三,上下文压缩。在每轮对话前,对历史上下文做裁剪——保留核心信息,丢弃冗余内容。行业数据显示,上下文压缩可减少 20%-35% 的输入 Token。
第四,工具编排优化。让 Agent 在调用工具前先做「路径规划」,而不是盲目全扫。Hermes 框架的一个设计思路是:Agent 会把经验自动生成 Skill(技能),减少反复试错。有开发者实测,同一任务 Hermes 消耗 50 万 Token,而另一个框架消耗 200 多万。
你的 Agent 在赔钱吗
一个简易判断公式:
Token 成本 ÷ 任务完成的商业价值 > 1 → 你的 Agent 在赔钱。
听起来像废话,但很多企业连这个简单的除法都没有做过。
Gartner 的报告指出,缺乏成本工程的 Agent 项目,运营支出平均超预算 300%。300% 是什么概念?你预算 10 万,实际花了 40 万。
这不是模型贵不贵的问题,而是你的 Agent 有没有缰绳的问题。LangChain 调查了 1300 多名从业者后发现:89% 的团队已经部署了可观测性工具,但只有 52% 在做离线评估。也就是说,大家看得见 Agent 在跑,但很少有人在算它跑得值不值。
这不是省钱的问题
Token 成本看起来是个技术问题,但它本质上是一个商业问题。
过去企业做数字化转型,云资源按需采购,SaaS 按年订阅,成本可预测。2025 年之后,AI 改变了游戏规则——Token 账单变成了一种「类似流量管控的动态计费」,企业 CTO 面对的是一张每月波动、难以预估的账单。
36 氪的一篇深度报道说得好:「在技术发展早期,没有浪费就没有进步。Token 浪费才会推动试错,Agent 会在技术进化和市场选择中不断成熟。」
但成熟的过程不能完全靠「烧」。谁能用更少的 Token 完成同样的任务,谁就拥有更高的利润空间。
这不是省钱的问题。这是你的 Agent 能不能活到明天的问题。
参考资料
1. 36氪/财经《今天,50%的Token正在被浪费》,2026年4月
2. Gartner 2026 AI Agent 成本工程报告
3. LangChain《State of Agent Engineering》,1300+从业者调研,2026年6月
4. 浙江大学《Stop Wasting Your Tokens》ICLR 2026
5. 腾讯云开发者社区《驯服"Token吞金兽"》,2026年7月
6. 《财经》Agent Token消耗实测数据,2026年3-4月
如果你也在做 AI Agent 部署,大概率你也面对过同样的问题——Token 账单突然暴涨,但说不清楚钱花在了哪里。
每周分享 AI Agent 落地实战经验、成本优化方案和行业案例