- 看清Agent从POC到生产的真实瓶颈——不是模型,不是成本
- 理解「可观测性89% vs 评估52%」背后的37个百分点鸿沟
- 拿到一套Agent工程成熟度五级自检框架
- 看到万人企业与百人公司在Agent落地上的关键差异
- 知道Agent评估的三种主流方法各自适合什么场景
LangChain在2026年6月发布了一份调研报告,调查了1340位专业人士。其中一个数字让我不太舒服——
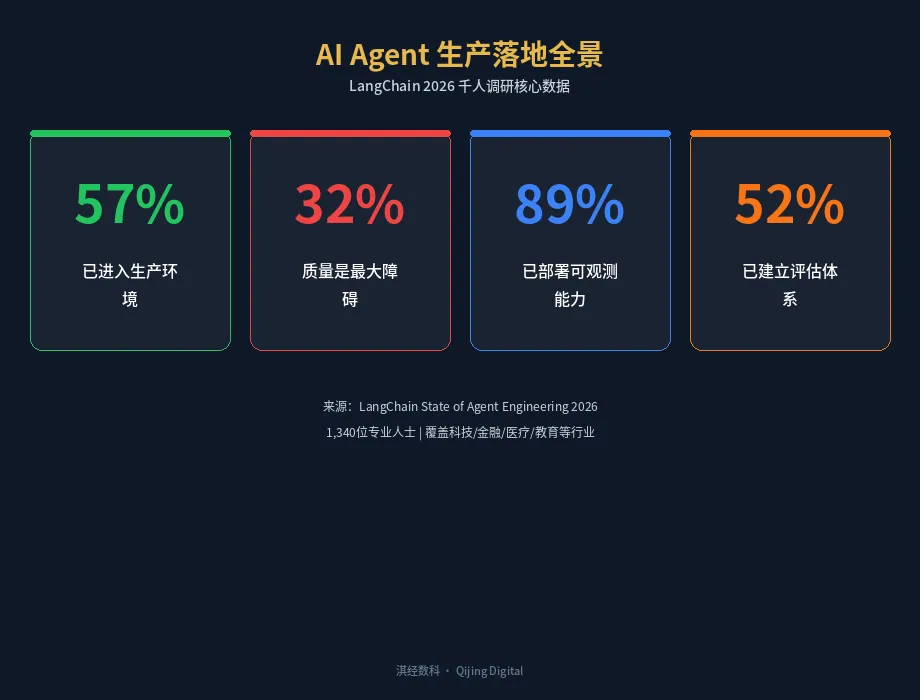
这不是个别现象。调研显示,57%的团队已经把Agent推进了生产环境。Agent不再是一个「要不要做」的问题,而是一个「怎么做对」的问题。
但「怎么做对」这四个字,很多人理解偏了。
质量问题不是模型问题
调研中最扎眼的数据是这个:32%的团队把「质量」列为Agent上生产的头号障碍。这个比例连续两年排名第一,而且还在上升。
很多人看到这个数据的第一反应是:「模型不行。」
但如果你仔细看调研里的细分数据,会发现另一个事实——
两个群体对「质量」的定义也不一样。万人企业的填写回复里,最频繁出现的词是「幻觉」和「输出一致性」——Agent有时候答对,有时候答错,同一个问题问两遍给两个答案。这对面向客户的场景是致命的。
3M在部署AI辅助客服时就遇到过这个问题。有用户问「3M的历史」,Agent回答「3M有80年历史」——但3M成立于1902年,到2026年已经超过120年。这种事实性错误在客服场景里,一次就够了。
看得见,但测不准
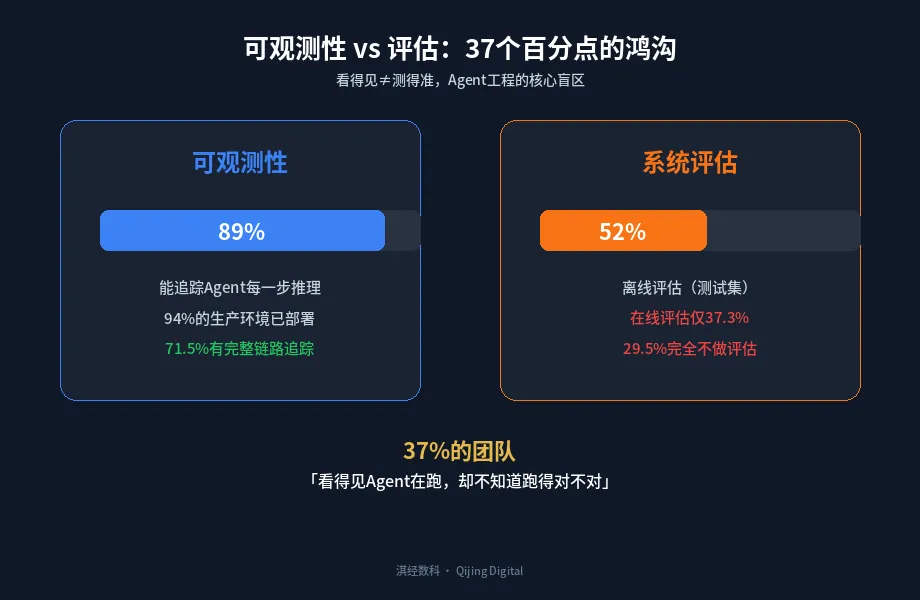
这就是那37个百分点鸿沟的真实含义。
可观测性解决的是「Agent做了什么」——每一步推理、每一次工具调用、每一个中间结果,都能追踪到。LangChain的数据显示,89%的团队已经部署了可观测能力,生产环境下更是高达94%。71.5%有完整的链路追踪。
但评估解决的是「Agent做得对不对」——它给出的答案是准确的吗?它的行为符合品牌规范吗?它的决策逻辑是可解释的吗?这个问题,只有52%的团队在回答。更扎心的是,在线评估(实时监控Agent在真实用户面前的表现)只有37.3%。
换句话说:大多数团队能看到Agent在跑,但不知道它跑得好不好。
这就好比你给一辆车装了行车记录仪,能拍到每一秒的画面。但你没装碰撞测试——你不知道这辆车在事故中能不能保护乘客。
评估的三条路
调研里还有一个有意思的发现:评估Agent质量的方法正在分化。
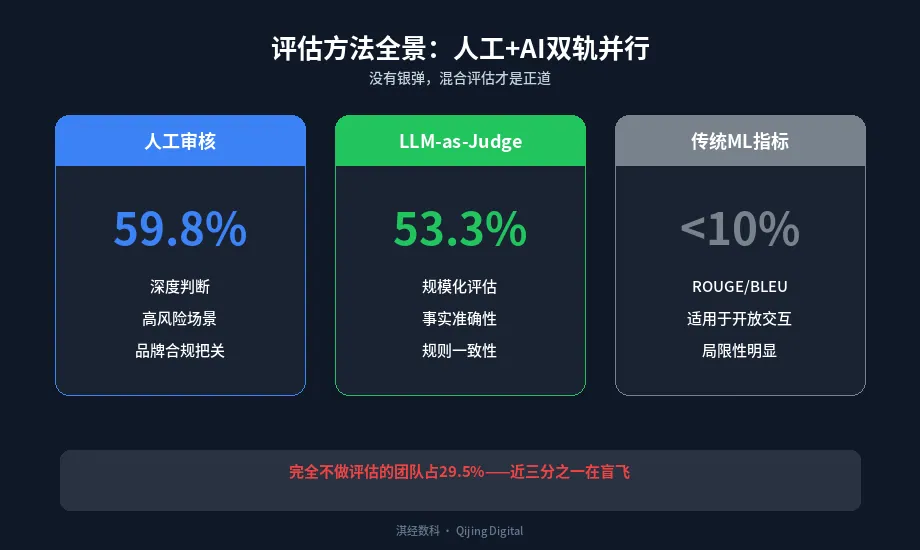
第一条路:人工审核(59.8%)。最传统也最可靠。让真人检查Agent的输出,判断准确性、语气、合规性。适合高风险场景——面向客户的回答、涉及品牌的表述、需要主观判断的内容。缺点是慢、贵、不可规模化。
第二条路:LLM-as-Judge(53.3%)。用另一个AI来评判Agent的输出。规模化能力强,可以同时检查成千上万条输出。适合事实准确性验证、规则一致性检查。但它本质上还是一个模型在评判另一个模型——「用AI审AI」的天花板在哪里,目前还没有共识。
第三条路:传统ML指标(低于10%)。ROUGE、BLEU这类经典的文本相似度指标。调研显示采用率很低,原因也简单——Agent的输出是开放式的,不像翻译任务有标准答案。多个有效回答并存时,BLEU分数毫无意义。
29.5%的团队完全不做评估。这不是「还没来得及」,是根本没有这个意识。
大企业卡安全,小公司卡速度
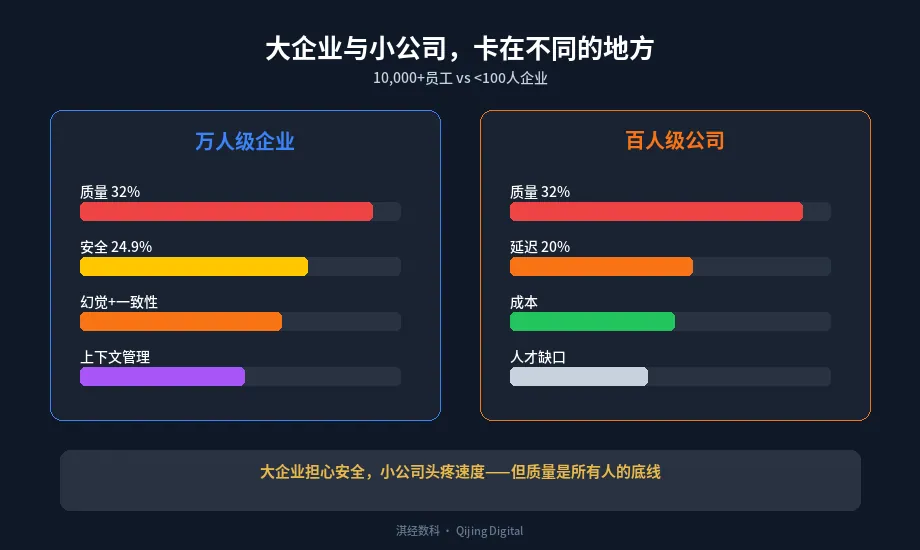
调研按企业规模拆了数据,差异很明显。
2000人以上的企业里,安全(24.9%)排在第二位。大企业有合规团队、有数据安全制度、有客户隐私保护要求——Agent如果在回答中泄露了内部数据,或者输出了违反合规的内容,后果不是道歉就能解决的。
万人企业的填写回复里反复出现「幻觉」和「一致性」这两个词。他们不怕Agent慢,怕的是Agent不靠谱。谷轮在部署内部知识助手时就定了一条铁律:任何涉及产品参数的回答,必须附带来源链接。宁可答「我不确定」,也不能编造一个数字。
百人公司的情况不同。延迟(20%)排第二——小公司的Agent往往直接面对终端用户,响应速度直接影响转化率。用户不会等30秒才看到一个回答。爱优特在部署获客Agent时做过测试:响应时间从8秒降到3秒,用户留存率提升了22%。
成本焦虑为什么退潮了?
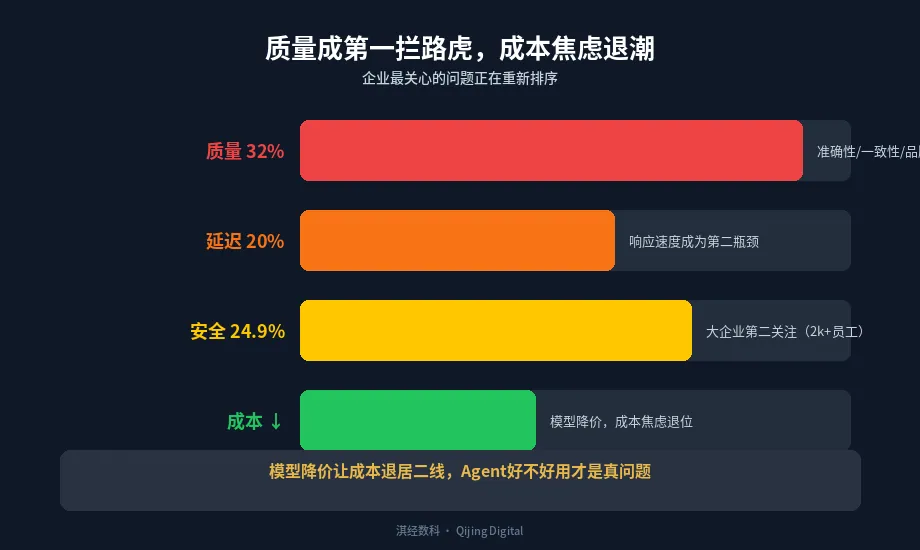
调研里有一个反直觉的变化:成本从前几年的前三名掉到了第四位。
原因不复杂——模型降价了。GPT-4o的API价格在两年内降了超过80%,开源模型(Llama、Qwen)在很多任务上已经够用。成本不再是「能不能用」的问题,而是「怎么用好」的问题。
这个转变意味着什么?
IDC预测2026年中国企业级AI智能体市场规模将达到449亿元,同比增长110%。市场在爆发,但爆发的基础不是「AI便宜了」,而是「AI可靠了」。可靠性的来源不是更好的模型,而是更好的工程。
Agent工程成熟度:你在哪一层?
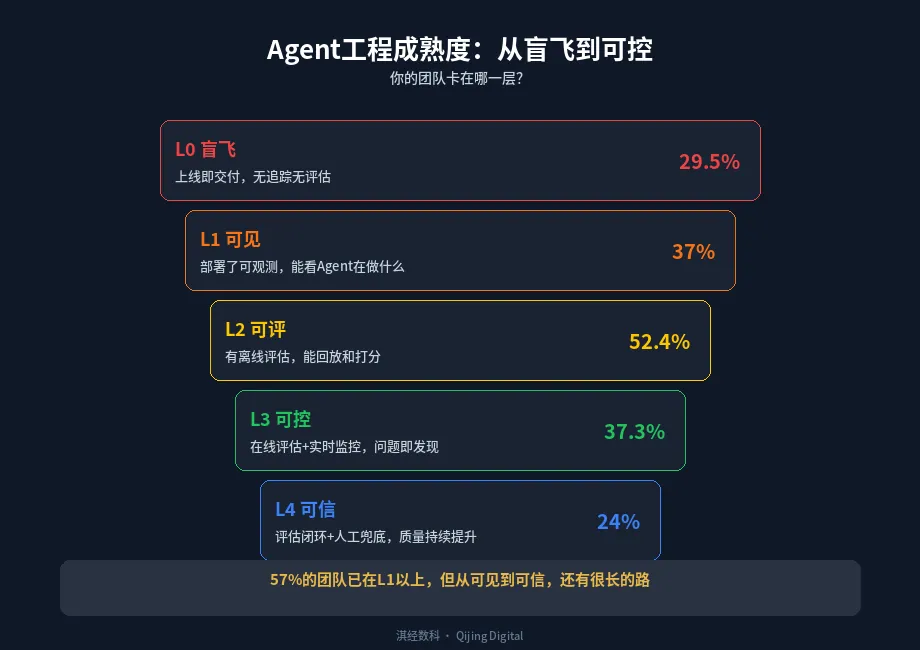
基于调研数据和我们自己的部署经验,我整理了一个Agent工程成熟度框架:
L0 盲飞——上线即交付,没有追踪、没有评估、没有监控。出了问题靠用户投诉发现。调研里29.5%的团队在这个阶段。
L1 可见——部署了可观测能力,能看到Agent的每一步推理。知道它做了什么,但不确定做得对不对。这是大多数团队(约37%)当前的位置。
L2 可评——建立了离线评估体系,能用测试集回放Agent的行为,打分、对比、发现退化。52.4%的团队到达了这一层。
L3 可控——在线评估+实时监控,Agent在真实用户面前的表现能被即时检测。出了问题能自动报警。37.3%的团队在这里。
L4 可信——评估闭环+人工兜底+持续迭代。Agent的质量不是一次达标的,而是一个持续改进的过程。这是终极目标,目前只有约24%的团队接近这个水平。
57%的团队已经在L1以上。但从「可见」到「可信」,中间隔的不是技术,是纪律。
别盯着模型,盯着工程
调研最后有一个数据让我印象深刻:75%以上的团队在生产环境中使用多个模型。OpenAI的GPT仍然是主流,但Gemini、Claude、开源模型都在被使用。团队会根据任务的复杂度、成本、延迟要求,把任务路由到不同的模型。
这说明什么?
模型的选择已经不是核心问题了。真正的问题是:你有没有一套工程体系,让这些模型在你的业务场景里稳定地工作。
这套工程体系包括:
可观测性——Agent的每一步推理、每一次工具调用都能被追踪和审计
评估体系——离线测试集+在线实时监控,两种手段缺一不可
人工兜底——高风险场景必须有人工审核环节,不能完全自动化
持续迭代——Agent的质量不是上线那天决定的,是上线之后每天优化的结果
这不是什么新道理。软件工程搞了几十年的CI/CD、代码审查、自动化测试、监控告警——Agent工程需要同样的纪律,只是换了一个载体。
32%的团队说质量是最大障碍。但质量不是障碍,质量是结果。真正的原因是:你有没有把Agent当成一个需要工程纪律来对待的系统,而不是一个调一下prompt就能上线的工具。
谁拖慢了智能体?不是模型,不是成本,不是工具链。
是缺少工程纪律的我们自己。
淇经服务的客户都在关注这些问题
3M · 谷轮 · 思帕 · 爱优特 · M77 · 香奈艺居 · 百世集团 —— 从全球500强到国内头部品牌,Agent的可靠性工程已经成为企业AI落地的核心议题。
如果你的团队也在面对「Agent上了生产但质量不稳定」的困境,淇经的FDE团队可以帮你从架构层面诊断问题、建立评估体系。
觉得有用?分享给你团队里负责AI落地的同事
保存这篇文章,下次Agent出问题时翻出来对照
全文完
淇经数科 · Qijing Digital | AI Agent 部署与交付
本文同步自淇经数科公众号(2026-09-12-谁拖慢了智能体-AI),文中数据与案例以真实交付为准。
想知道 AI 现在怎么介绍你的品牌?免费获取《品牌 AI 可见度诊断报告》:AI 说了什么、说错在哪、同行占了多少位置。