• 看懂「78%企业有Agent试点、不到15%投产」的真正原因
• 掌握三级评估漏斗(结局→轨迹→组件)的实操方法
• 拿到上线前五道自检门槛的执行清单
• 理解为什么「通过率70%」远不是「够用了」
• 学会把每次生产事故变成永久回归用例
Demo跑通了,上线翻车了?
你可能觉得"测试全过了,可以上线了吧?"
LangChain 2026年调查了1300多名从业者后,发现一个残酷的事实:很多AI智能体在测试阶段表现不错,一到真实环境就频频翻车。
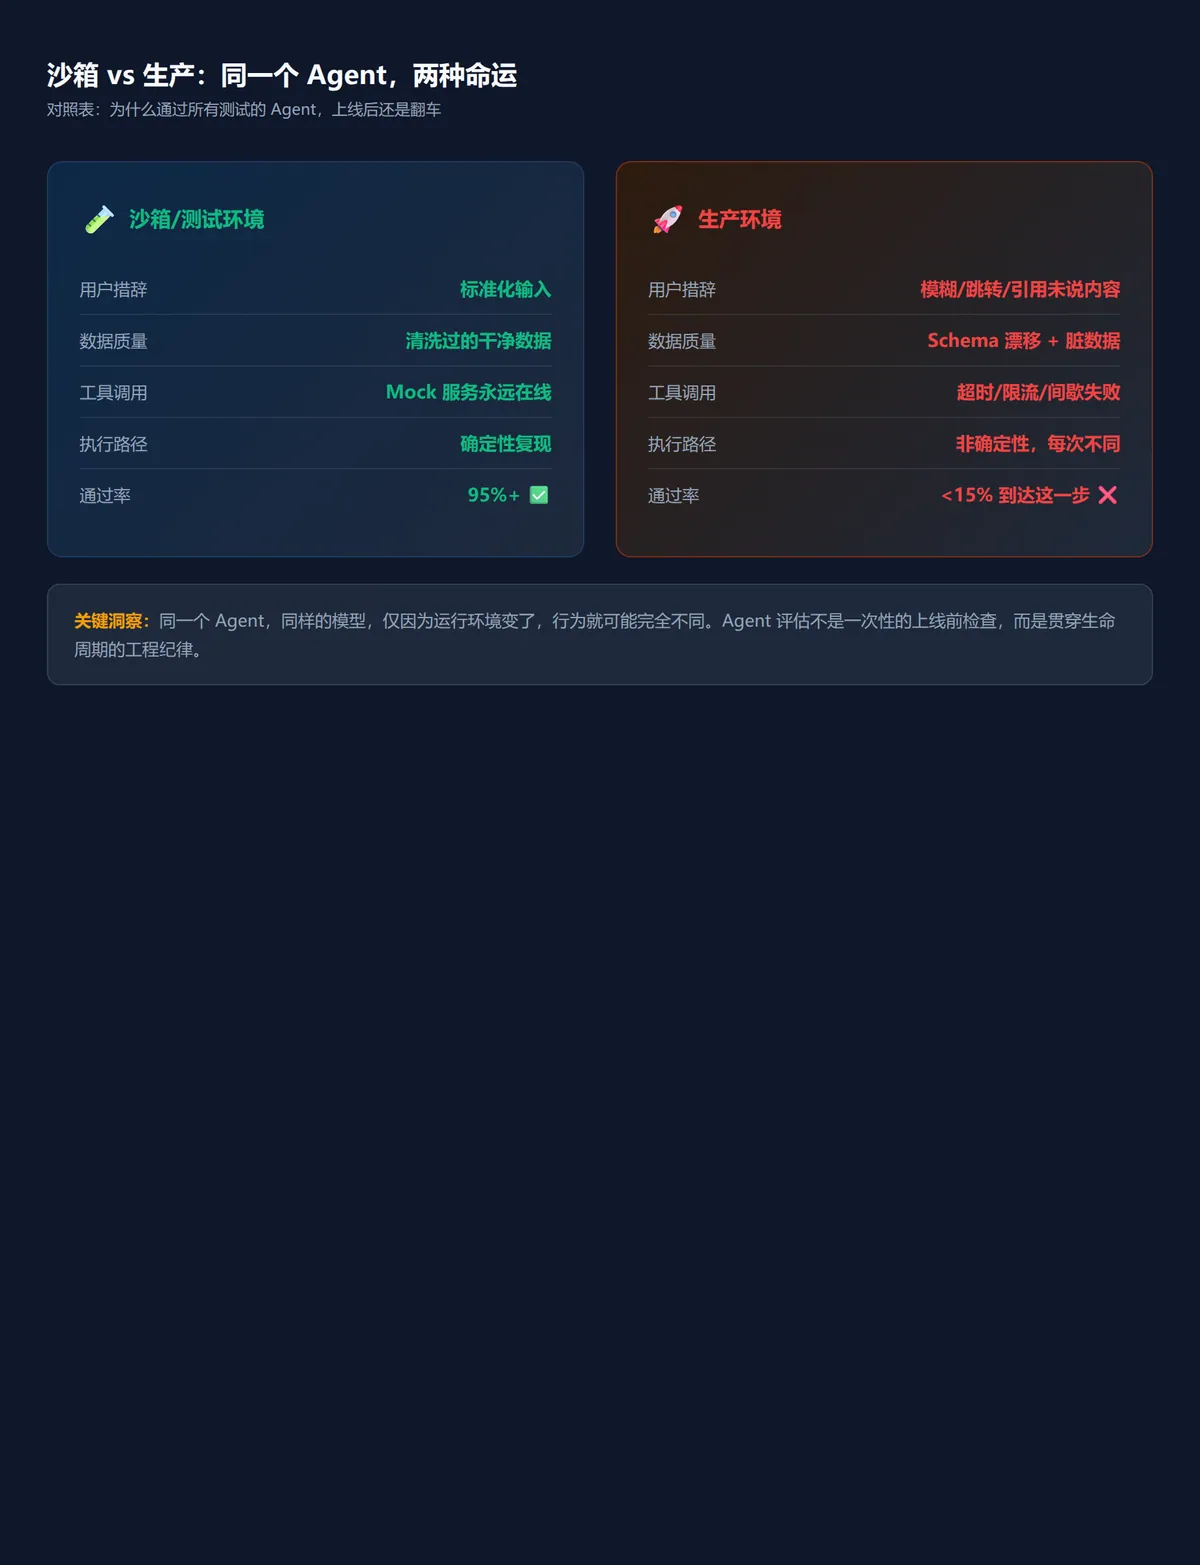
原因不复杂——测试时你控制了变量,生产时用户不会配合你。他们措辞模糊、中途变卦、引用从未明说的上下文。底层数据在漂移,工具调用在超时,你精心设计的Agent,正在一个完全不同的世界里运行。
这不是模型的问题,也不是Agent"不够聪明"。这是一整套评估体系缺失的问题。
为什么同一个Agent,沙箱里能跑、生产环境就翻车?
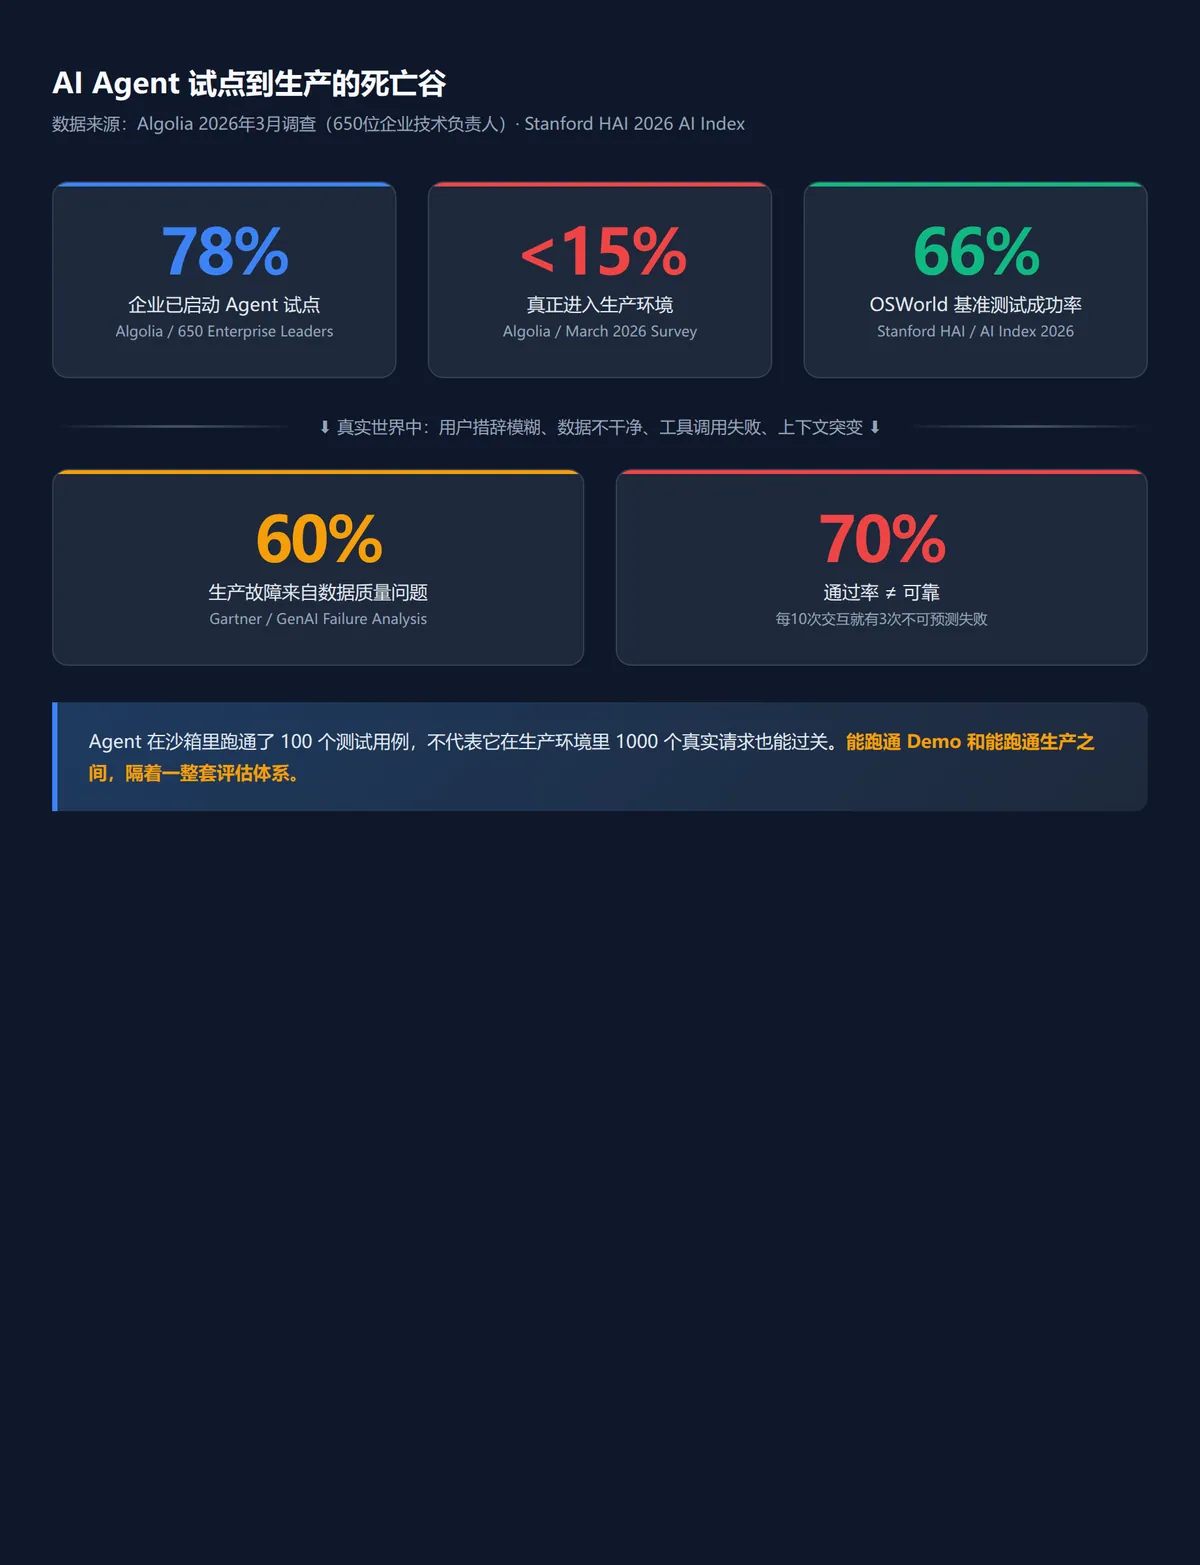
2026年3月,Algolia对650位企业技术负责人做了一次大规模调查。结论直白:78%的企业已经启动了AI Agent试点,但不到15%真正进入了生产环境。
这个15%的数字背后,藏着Agent架构和传统LLM应用最本质的区别。
传统LLM应用是"输入→输出"的单次对话:你给一段文字,模型返回一段文字。评估很简单——答案对不对、相关不相关、有没有幻觉。
但Agent不一样。Agent是"思考→决定→行动→观察→再思考"的循环。每一步都可能出错:
思考阶段:推理链是否合理?前提假设对不对?
决策阶段:选了正确的工具吗?参数填对了吗?
执行阶段:工具返回的结果可靠吗?有超时或降级吗?
观察阶段:拿到的结果能支撑下一步推理吗?
Gartner的统计更扎心:60%的AI生产故障来自数据质量问题——过期文档、Schema漂移、未验证来源——而不是模型本身的局限。
换句话说,你的Agent可能推理完全正确,但因为引用了一份过期的政策文档,输出了一个看起来很专业但完全错误的答案。这种错误,通过传统测试几乎不可能发现。
三级评估漏斗:从"结果对不对"到"哪一步出了错"
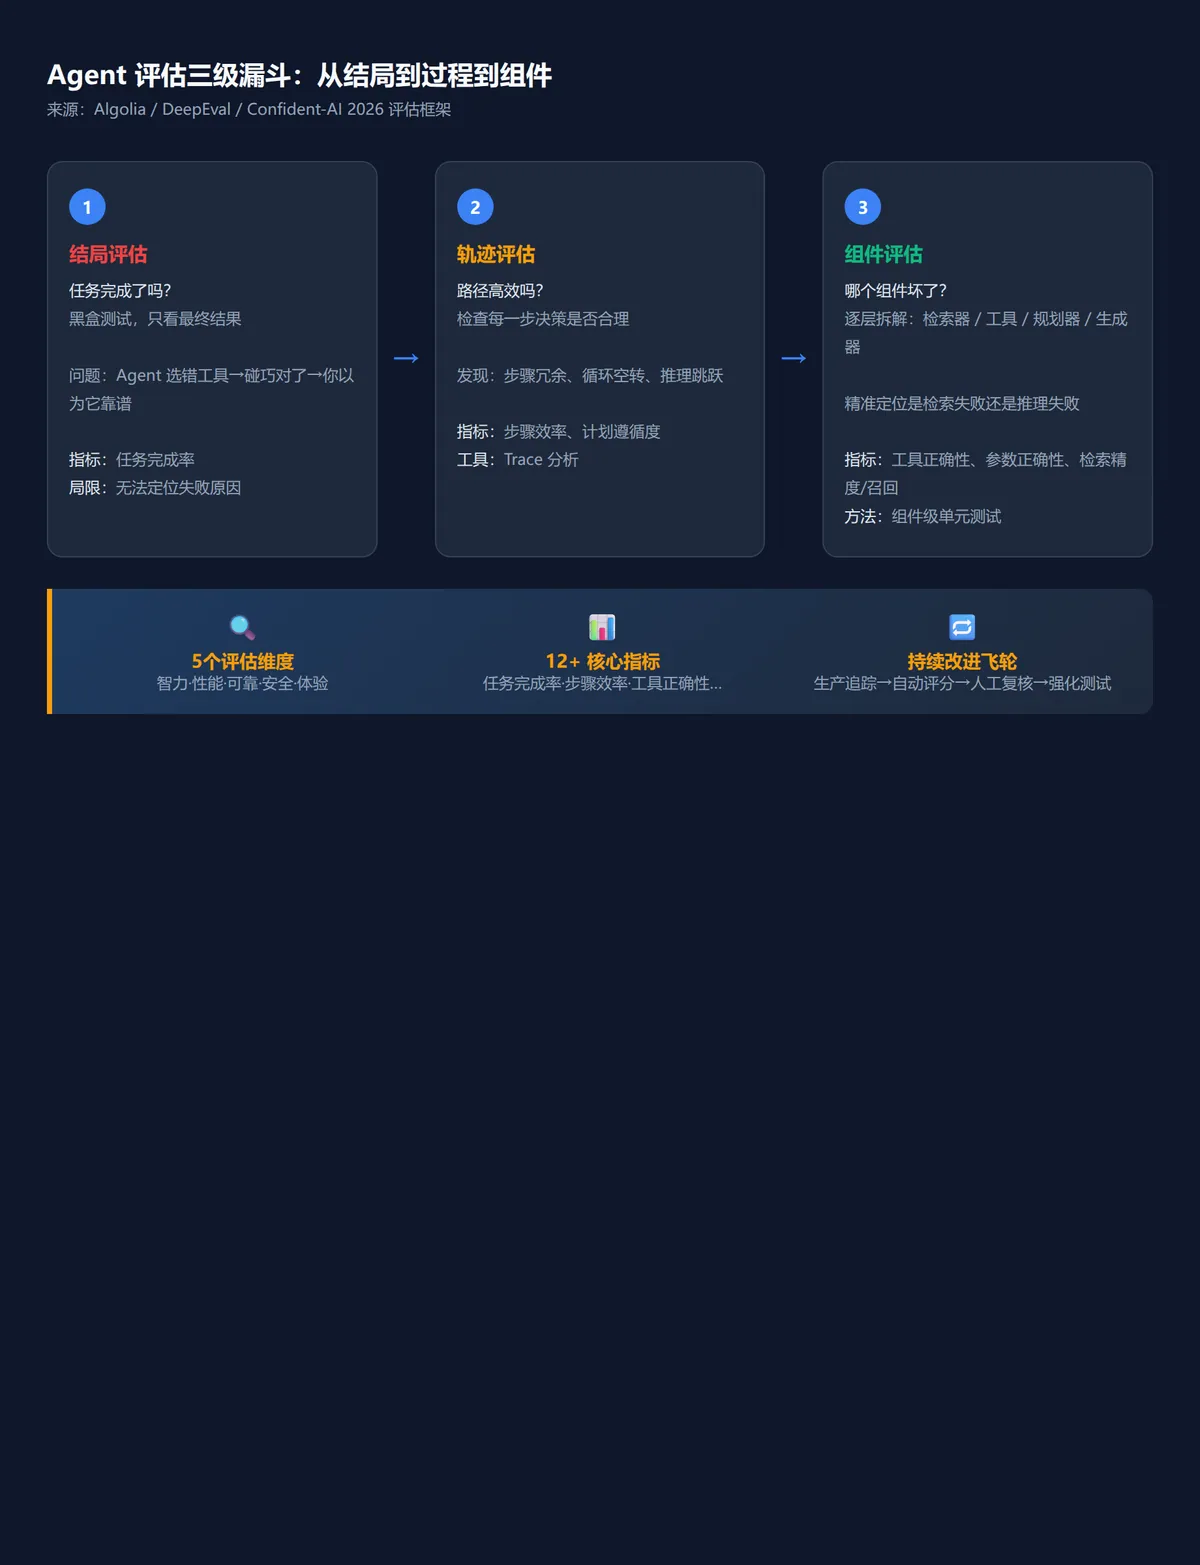
既然Agent的失败不是"对错"二分法能覆盖的,评估体系就得跟着升级。2026年业界共识是三级漏斗——先看结局,再查路径,最后拆组件。
第一级:结局评估——任务完成了吗?
这是最基础的一层:把Agent当黑盒,只看最终结果。比如你让Agent"帮我查一下3M最近的营收数据并生成报告",结局评估只关心报告是否生成、数据是否正确。
问题在于:Agent可能选错了工具、走了弯路,最后碰巧得到了正确结果。这时候,结局评估会告诉你"通过了",但掩盖了一个系统性的决策缺陷——下次遇到稍微不同的条件,同样的"碰巧"不会发生。
实操建议:用LLM-as-Judge对每条Trace打分,但要注意——Judge本身需要人工校准。拿几百条人工评分的Trace来校准Judge的评分标准,否则Judge的"判断"可能和人类偏差越来越大。
第二级:轨迹评估——路径高效吗?
轨迹评估打开黑盒,检查Agent每一步决策是否合理。典型问题:
步骤冗余:调了5次API才完成1次就能搞定的事
循环空转:反复尝试同一个已经失败的路径
推理跳跃:上一步的数据明明不支持当前结论,但Agent直接跳到了结论
这里用得最多的工具是Trace分析。每次Agent执行任务,记录完整的执行轨迹——哪些工具被调用了、参数是什么、中间结果如何、推理链是什么样的。然后对Trace做自动化评分,定期人工抽样复核。
一个实用技巧:做扰动测试。把输入换一种说法、替换同义词、重排上下文顺序,看推理路径是否保持稳定。如果换个说法Agent就走了一条完全不同的路,那它的决策机制大概率有问题。
第三级:组件评估——哪个零件坏了?
这是最深层的评估。Agent是一个多组件系统——检索器、规划器、工具链、生成器——任何一个组件出问题,最终输出都会受影响。
组件评估的关键是分层测试:单独测试检索器的精度和召回,单独测试每个工具调用的正确性和参数正确性,单独测试规划器的逻辑连贯性。当一个端到端评估失败时,你能精确定位是检索层的问题还是推理层的问题,修复方案完全不同。
Confident-AI总结的12个核心指标值得收藏:任务完成率、步骤效率、工具正确性、参数正确性、计划遵循度、计划质量、推理质量、回答相关性、忠实度、安全性、延迟、成本。不同类型的Agent,权重不同——面向客户的Agent重点看"有用"和"成功完成",研究型Agent重点看"忠实"和"检索准确"。
生产环境的四大失败面:不只一种翻车方式
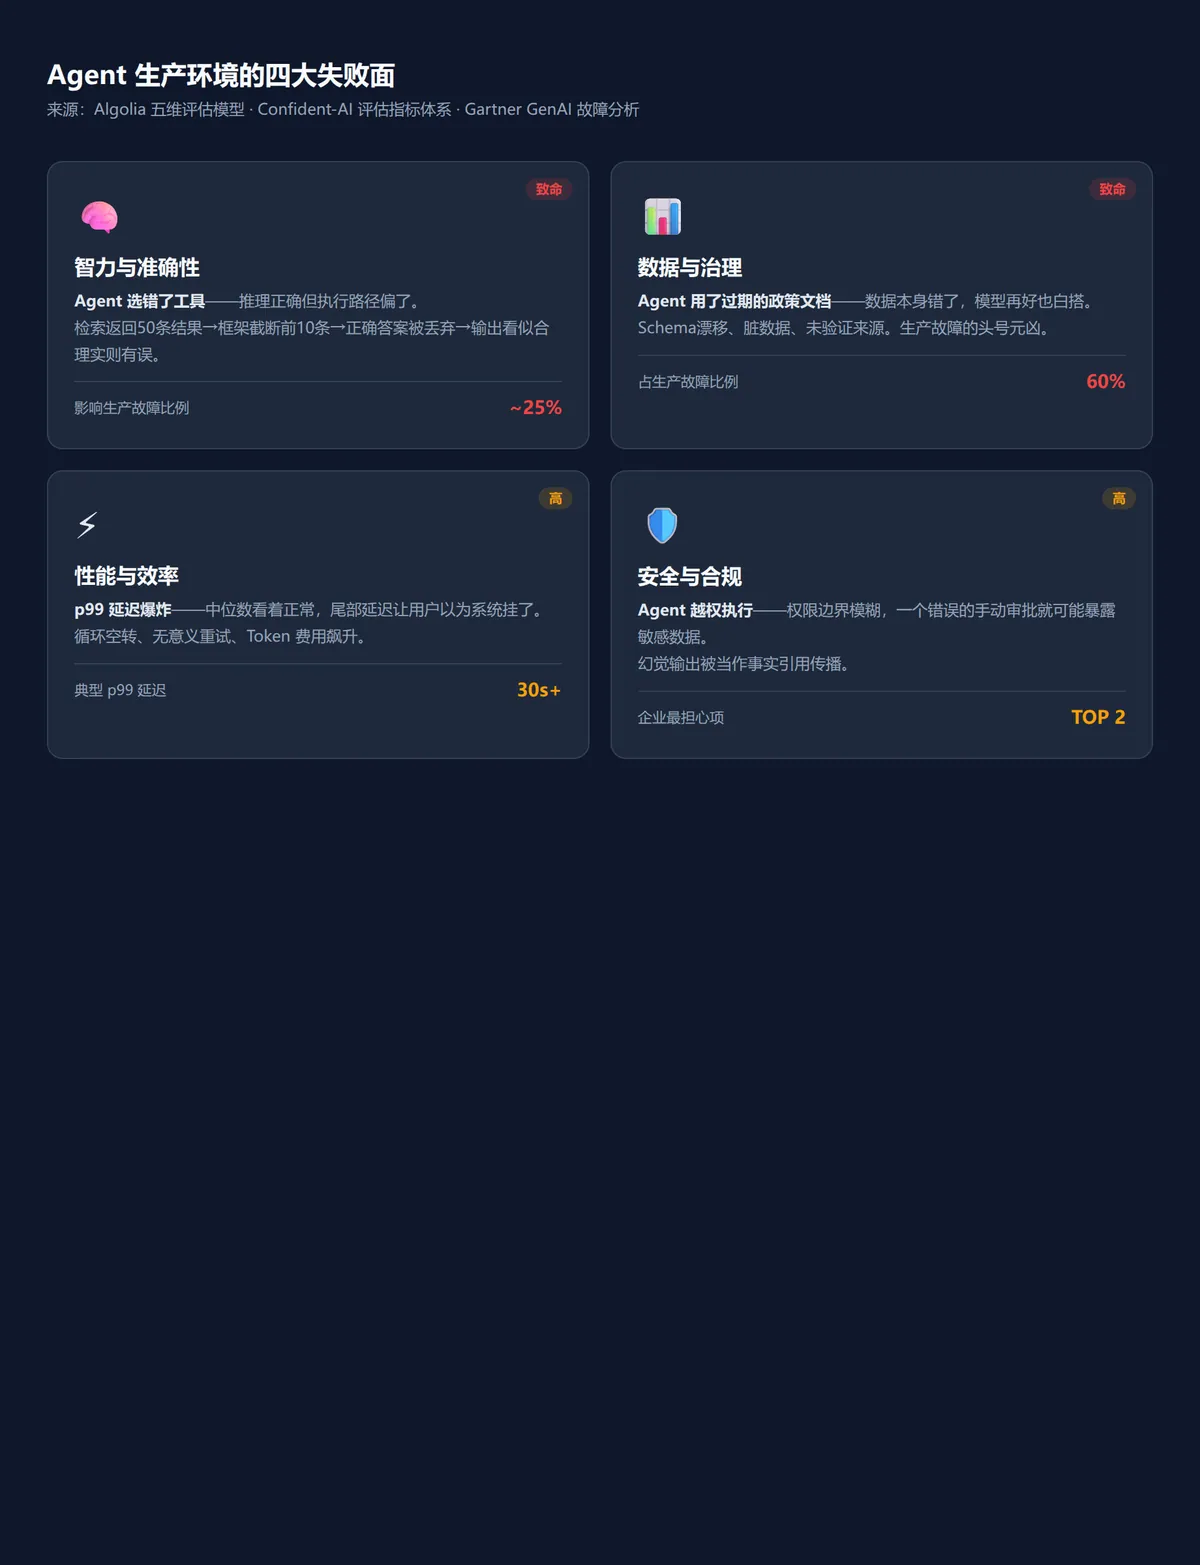
很多团队只盯着"答案对不对"这一个维度。但2026年的评估框架已经扩展到五个维度——智力与准确性、性能与效率、可靠性与韧性、安全与治理、用户体验。其中最容易被忽视的是:
数据与治理(60%故障来源):你的Agent引用的知识库最后更新是什么时候?Schema有没有漂移过?数据源是否经过验证?Agent自信满满地引用了一份过期三个月的政策文档——这是最常见的"看起来很对、实际全错"的翻车方式。
尾部延迟(p99才是真相):你的Agent中位延迟1.2秒,看起来很快。但p99延迟30秒以上——每100个用户就有1个要等半分钟以上。Agent循环调用工具、反复重试的场景下,尾部延迟会呈指数级增长。
非确定性路径:同一个问题问两遍,Agent可能走完全不同的路径。这对用户体验是灾难——用户无法预测系统行为,信任就建立不起来。
上线前五道自检门槛:从生产事故里提炼的铁律
说了这么多"会翻车",具体怎么防?我们从真实的Agent部署经验里,提炼出五道上线前必须过的门槛:
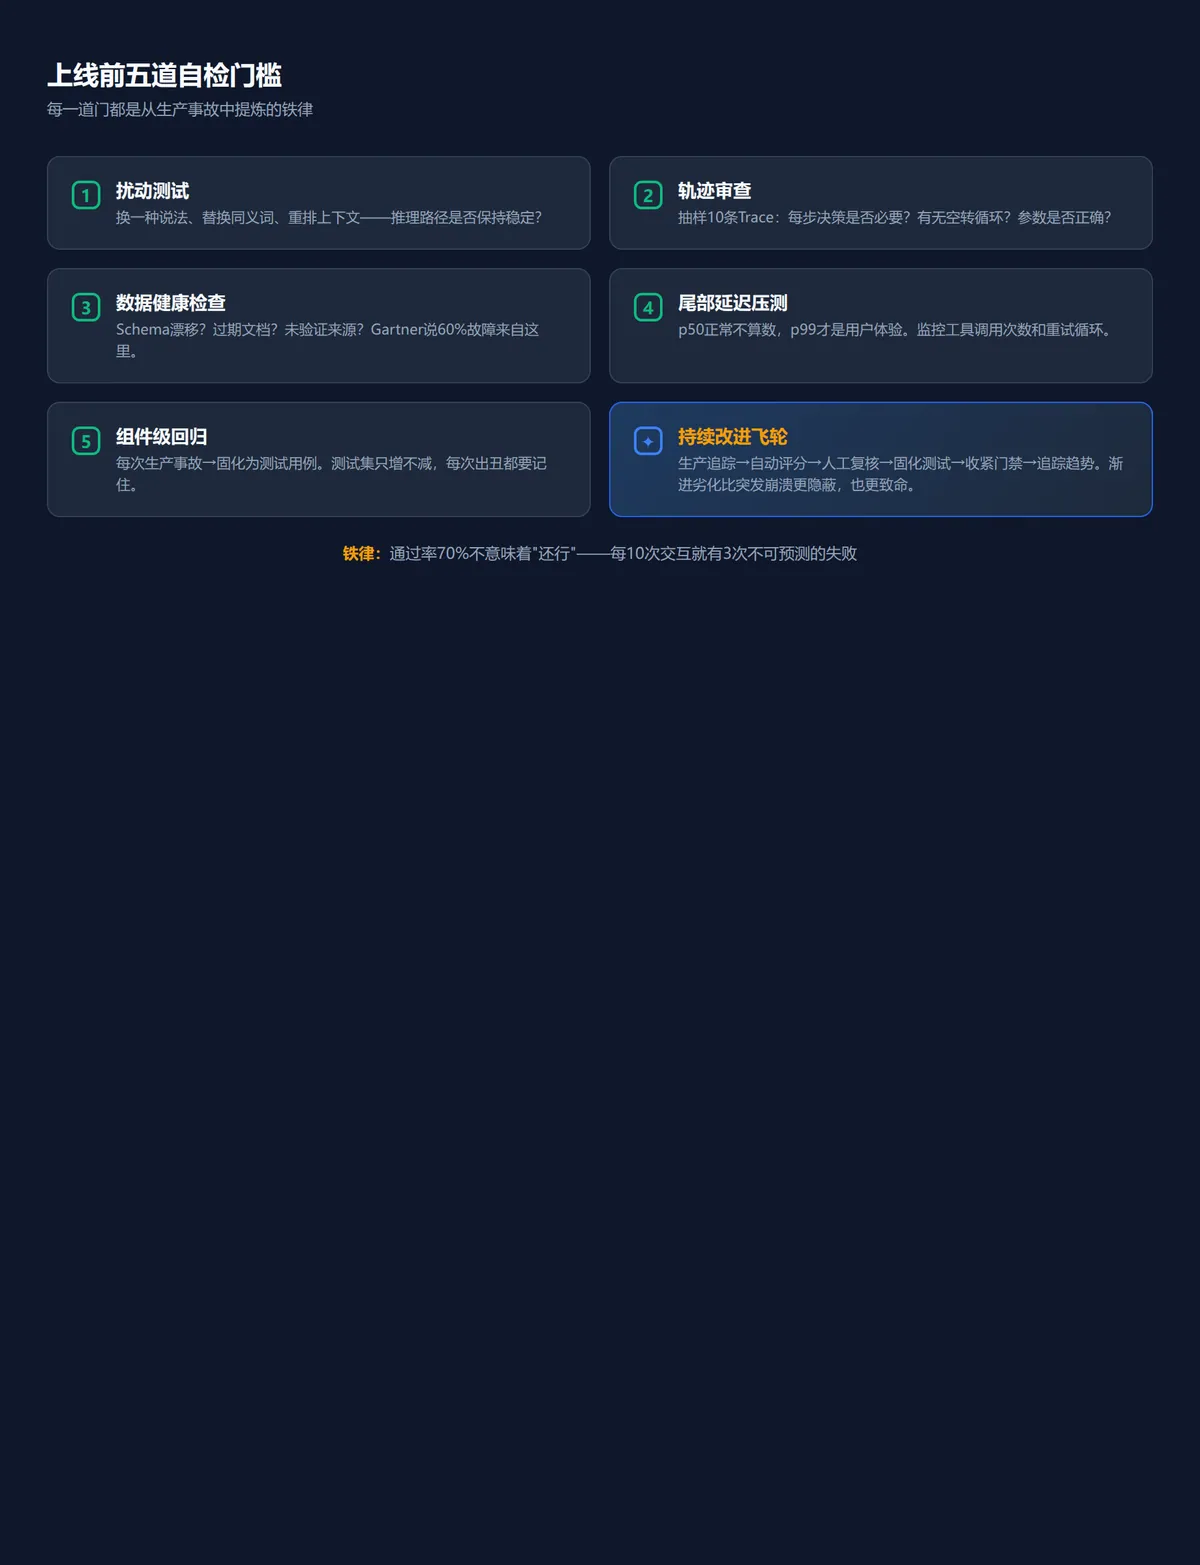
第一道:扰动测试——换一种说法、替换同义词、重排上下文,看推理路径是否保持稳定。如果换个问法Agent就走了一条完全不同的路,说明它的决策是"靠运气"而非"靠逻辑"。
第二道:轨迹审查——随机抽样10条Trace,逐行检查:每步决策是否必要?有无空转循环?工具参数是否正确?有没有"碰巧对了"的情况?
第三道:数据健康检查——Schema有没有漂移?知识库最后更新是什么时候?有没有未验证来源混入?这是60%生产故障的源头,但绝大多数开发测试里从不覆盖。
第四道:尾部延迟压测——别只看p50。p99延迟是多少?工具调用次数有没有异常膨胀?重试循环是否在浪费Token预算?Agent"正确但又慢又贵"在生产里同样算失败。
第五道:组件级回归——把每次生产事故固化为测试用例。测试集只增不减,每次出丑都要记住。Agent的可靠性不是"设计"出来的,是一次次翻车后"修"出来的。
一个数字要刻进脑子里:通过率70%不意味着"还行"。它意味着每10次交互就有3次不可预测的失败。在面向客户的场景里,这3次失败就是3次信任崩塌。
评估飞轮:从一次翻车到一套系统
2026年Agent评估领域最重要的趋势,是从"上线前一次性检查"转向"持续改进飞轮"。
飞轮长这样:生产追踪→自动评分→人工复核→固化测试用例→收紧部署门禁→趋势追踪。每一次生产事故都不是"修了就完了",而是变成一条新的回归用例,永远留在测试集里。
更隐蔽的杀手是渐进劣化。Agent的基座模型在更新,外部数据在变化,工具API在迭代——不像突发崩溃那样醒目,而是缓慢地、一点一点地降低质量。没有持续的趋势追踪,你可能几个月后才突然发现:怎么用户投诉变多了?
所以,评估不是上线前的一次性门禁,而是贯穿Agent生命周期的工程纪律。LangChain报告里说得很直白:把评估当作一次性部署前检查的团队,往往在真实用户行为、脏数据和基础设施小毛病面前吃大亏。
我们的实践:FDE怎么把评估工程化
说到Agent评估,不得不提我们淇经数科在FDE(前沿部署工程师)岗位上的实践。
我们服务的客户——从3M这样的外资500强,到谷轮、思帕这类专业制造企业,再到M77、香奈艺居等消费品牌——都有一个共同特点:Demo阶段看着挺好,真正要接入业务流程时各种问题冒出来。
我们总结出来的经验是三级漏斗+Trace闭环。具体来说:
1. 上线前:每个Agent部署前过五道门槛——扰动测试、轨迹审查、数据健康、尾部压测、组件回归。
2. 上线后:全量Trace采集+自动化评分,每天出评估报告。
3. 持续优化:每次生产异常→人工复核→固化为回归用例→更新评估标准。
举个具体的例子:我们曾给一家制造业客户部署了一个基于GEO的智能客服Agent。Demo阶段测试100个场景全部通过。正式上线第一周,用户真实提问的前20%都命中不了预设场景——因为用户不会像测试脚本那样"正确提问"。
经过一个月的Trace分析和持续优化,我们把Agent的场景覆盖从100个预设场景扩展到覆盖80%的真实提问模式,任务完成率从上线首周的不到30%提升到稳定在75%以上。这个过程中,每一条失败的Trace都变成了一条新的测试用例。
GEO系统后台的真实数据也佐证了这一点:我们持续监测的品牌数据采集准确率从初期的65%稳定提升到88%,关键词覆盖率从12个核心词扩展到47个——每一次数据修正背后,都是一次"发现问题→定位根因→固化修复"的评估闭环。
写在最后:能跑通Demo不算本事,能跑通生产才算
2026年是AI Agent从"概念验证"走向"生产部署"的关键年份。Stanford HAI报告显示,OSWorld基准测试的成功率已经从12%跃升到66.3%——技术在进步,模型在变强。
但技术能力的提升,不能替代工程体系的建设。78%有试点、不到15%投产的数字告诉我们:Agent的瓶颈不在模型能力,在于"你怎么知道它真的靠谱"。
如果你正在部署AI Agent,或者准备部署,不妨问自己三个问题:
1. 我的Agent上线前过了几道评估门槛?
2. 我的测试集最后一次更新是什么时候?
3. 我的Agent在生产环境的p99延迟是多少?
如果这三个问题你答不上来,那你的Agent可能还活在Demo的美好幻觉里。
评估体系不是"锦上添花",是Agent能否在生产环境生存的命脉。
💬 你在部署AI Agent时遇到过哪些"Demo能跑、生产翻车"的坑?