📖 导读:阅读本文你将获得:
• 搞懂「可观测性」不只是看日志,而是三层递进的体系
• 用「30分钟回滚测试」诊断你的Agent部署到底缺了哪一层
• 拿到一份面向企业决策者的可观测性选型决策树
• 了解2026年主流可观测性平台的分层能力与盲区
一个下午,三万条日志,没有一条告诉你真相
周五下午三点,运维群里弹了一条消息:「Agent把客户Q3的报价单覆盖了。」
你打开LangSmith,trace记录完整:12次工具调用,2847个token,耗时4.3秒,全部200 OK。你又翻了CloudWatch日志,延迟正常、内存正常、CPU正常。一切指标都在绿区——但客户的数据已经没了。
这不是假设。AWS在2026年发布的《Agentic AI基础设施实践》第七期里明确写道:传统的Metrics → Logs → Traces三支柱,在Agent场景只能告诉你「发生了什么」,却无法解释「为什么会这样」,更无法指明「下一步该怎么办」。
换句话说:你的监控系统在Agent出事的时候,跟瞎子一样。
问题的根因:你以为可观测性是一层,其实是三层
2026年5月,一周之内发生了三件事:Honeycomb发布了Agent Observability,LangChain推出了SmithDB,Microsoft Agent Framework进入stable。AI圈的每个基础设施团队都在问同一个问题:「Agent可观测性到底意味着什么?」
但这个问题把三层不同的东西塞进了同一个词。2026年一份覆盖七大平台的横评报告把这三层拆得非常清楚:
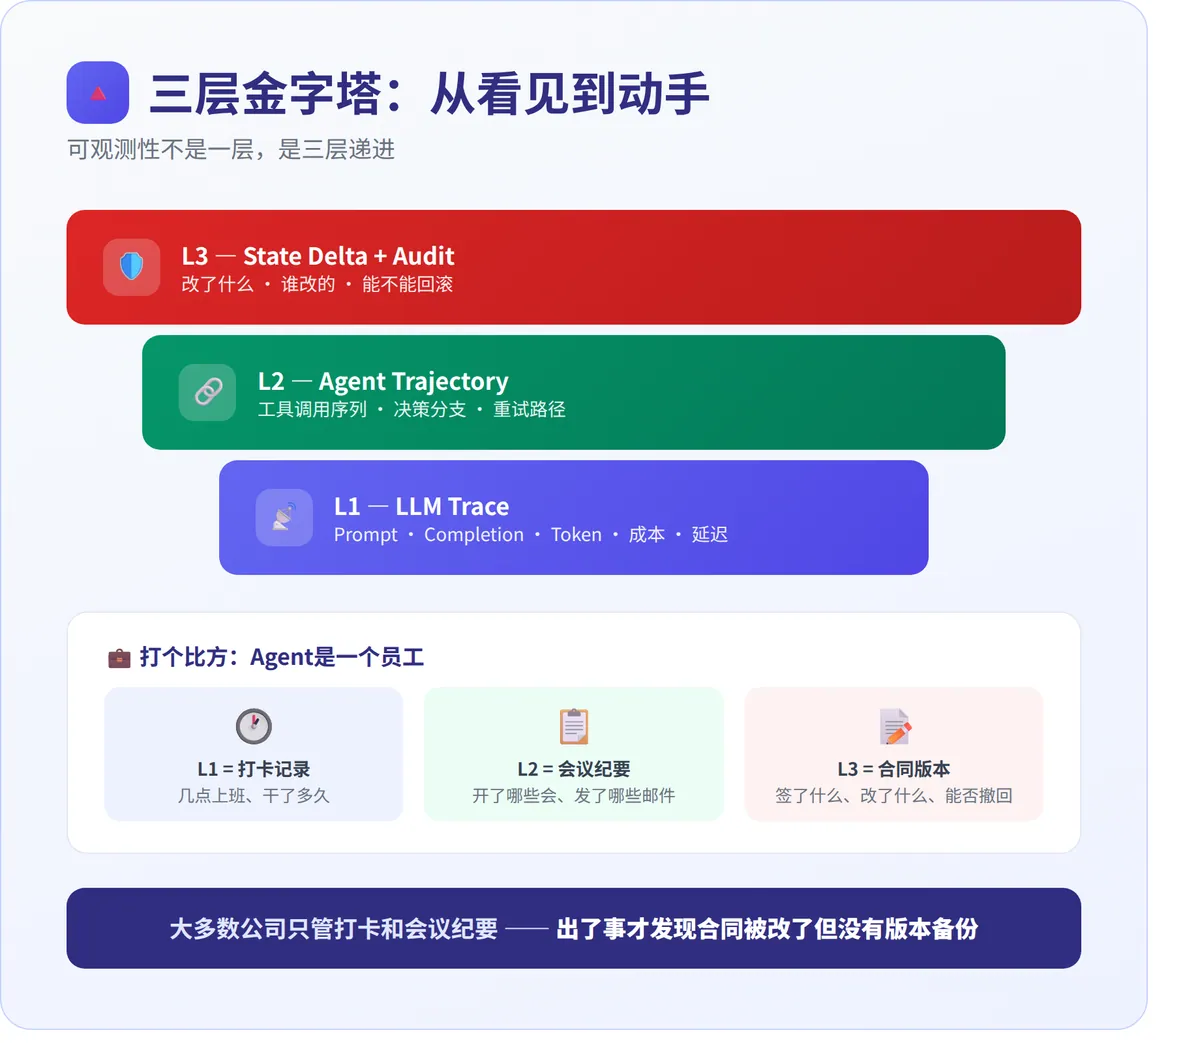
L1 — LLM Trace:模型调了什么、花了多少token、用了多久。这是你已经熟悉的「监控」。
L2 — Agent Trajectory:工具调用序列、决策分支、重试路径。这是2026年最拥挤的战场——LangSmith、Honeycomb、Arize、LangFuse、Helicone、Phoenix、Superlog七家在同时卷。
L3 — State Delta + Audit:Agent到底改了世界上的什么、谁为这次改动负责、能不能回滚。这是产品空白——多数团队靠Git、CDC或自建webhook凑出来。
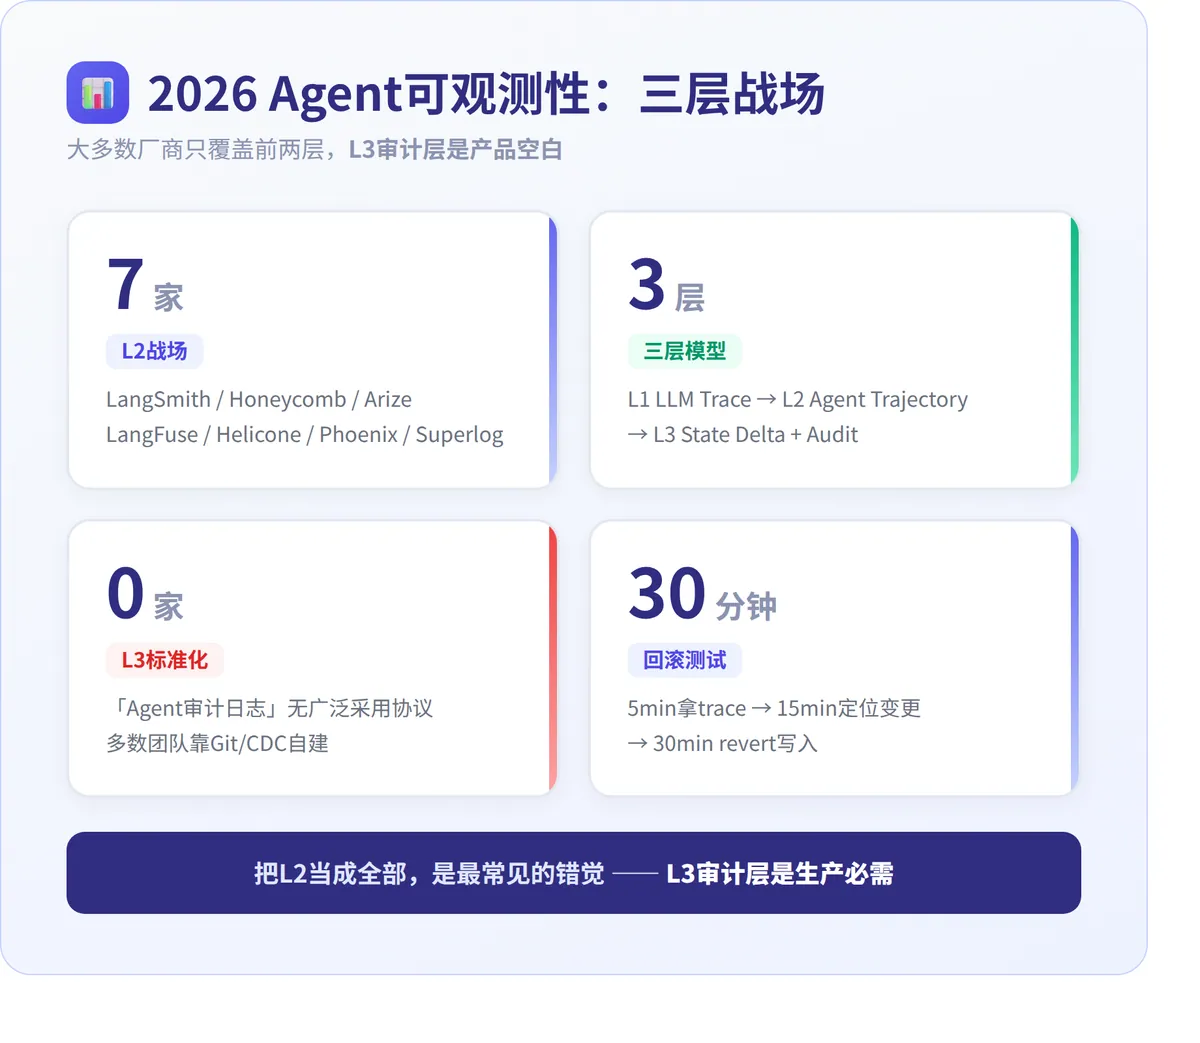
把L2当成全部,是最常见的错觉。
三层能看见什么、看不见什么
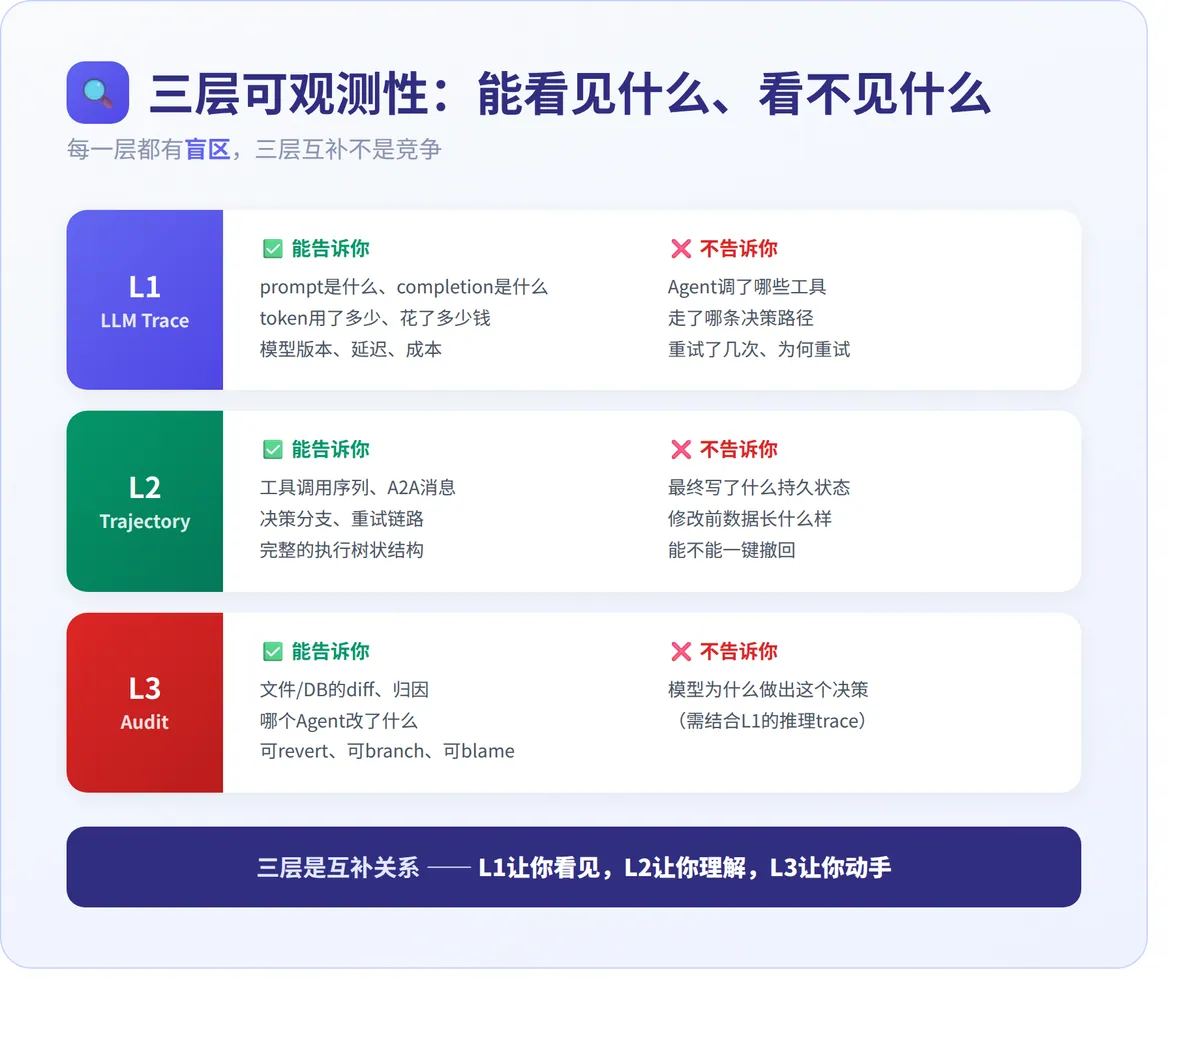
打个比方:Agent是一个员工,L1是他的打卡记录,L2是他今天开了哪些会、发了哪些邮件,L3是他签过的合同和改过的文件。大多数公司只管打卡和会议纪要,出了事才发现合同被改了但没有版本备份。
L1 能告诉你:prompt是什么、completion是什么、token用了多少、花了多少钱、模型版本是什么。
L1 不告诉你:Agent调了哪些工具、走了哪条决策路径、重试了几次。
L2 能告诉你:工具调用序列、A2A消息、决策分支、重试链路。
L2 不告诉你:Agent最终写了什么持久状态、这次写入前数据长什么样、能不能撤回。
L3 能告诉你:文件/数据库/共享上下文的diff、归因(哪个Agent改的)、可回滚。Git在代码领域开创的那一套——diff、author、revert、branch、blame——套到Agent写出的状态上。
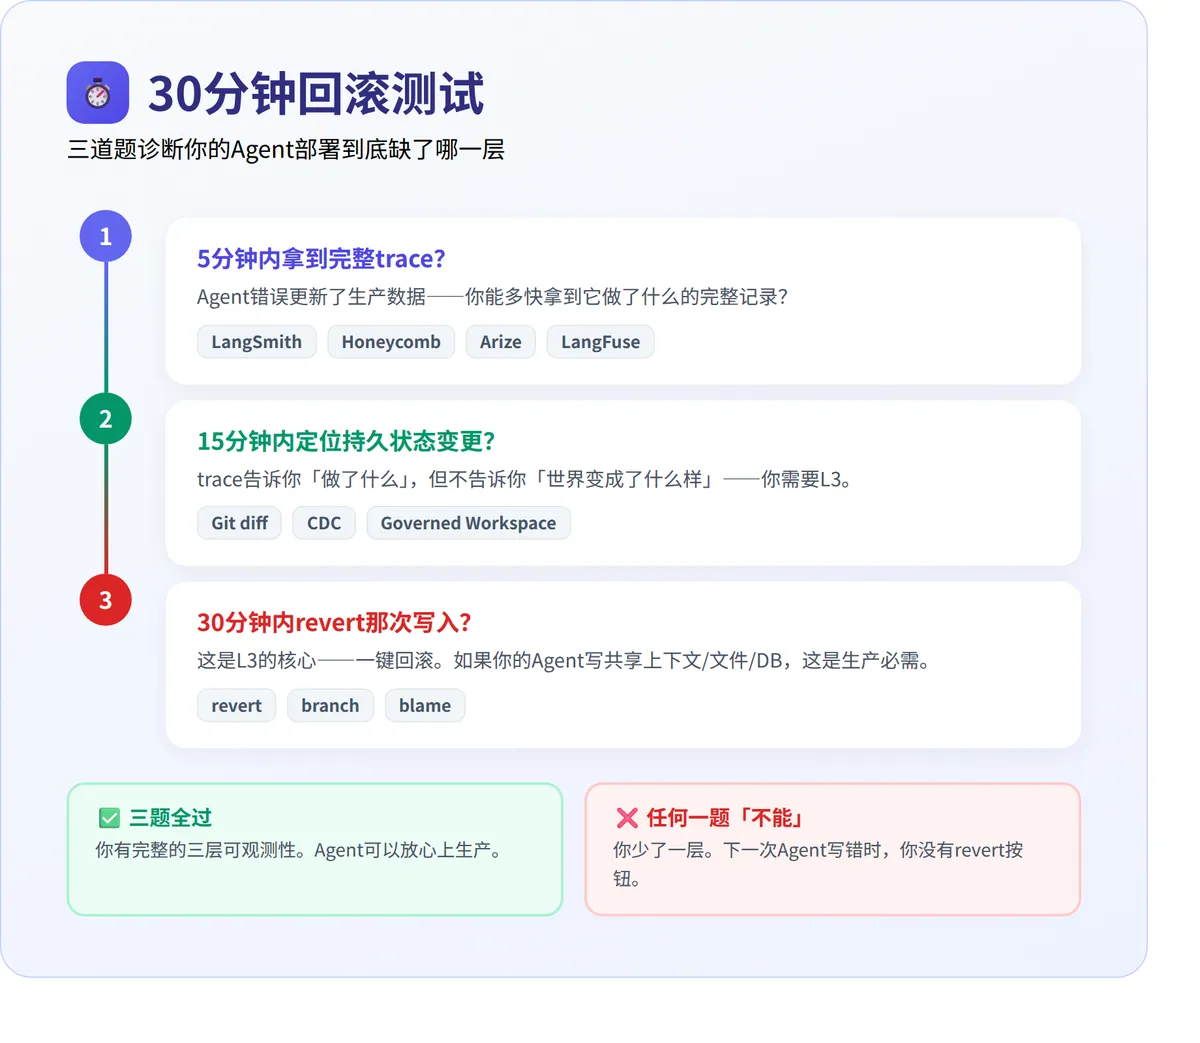
30分钟回滚测试:你的Agent缺了哪一层
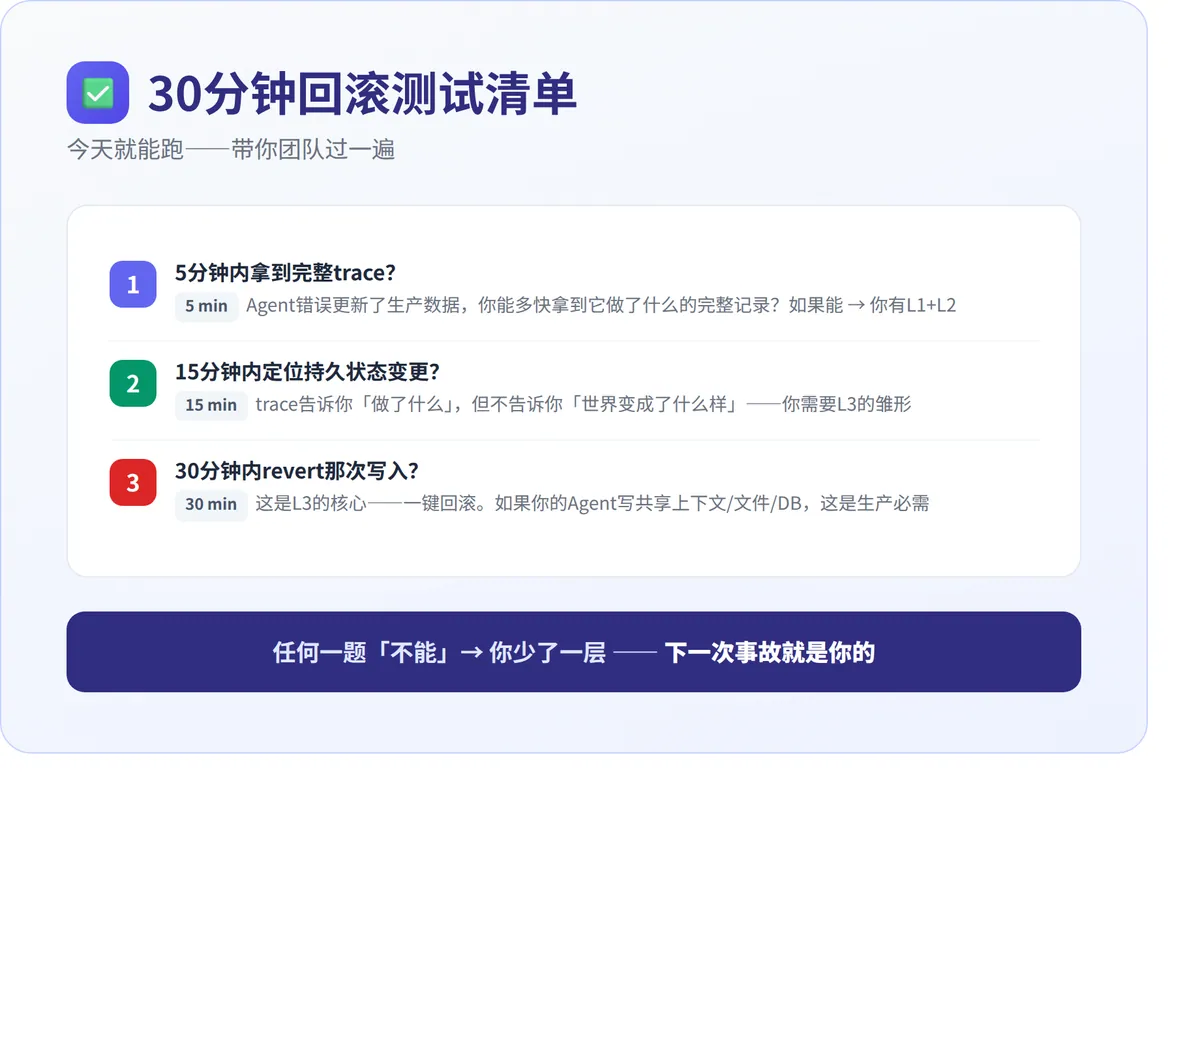
下次选型或审计自己的stack,让团队走一遍这三道题:
1. 当一个Agent错误更新了生产数据,5分钟内能不能拿到完整trace?
如果能,恭喜——你至少有L1+L2。这一层,LangSmith、Honeycomb、Arize、LangFuse都能做到。
2. 15分钟内能不能定位到具体改了哪些持久状态?
trace告诉你Agent「做了什么」,但不告诉你「世界因此变成了什么样」。你需要L3——某个Agent更新了Notion上的OKR页,trace记录了450ms、200 OK,但它不告诉你那一页更新之前长什么样。
3. 30分钟内能不能revert那次写入?
这是L3的核心。如果你的Agent会写共享上下文、文件、数据库,仅靠L1+L2上不了生产。审计层是必需的。多数团队都是被一次生产事故逼着才发现这层缺失。
你的场景需要几层?一棵决策树
场景一:单Agent demo/POC
只需L1。LangFuse(开源)或Helicone(集成成本最低),免费档够用。
场景二:单Agent生产,不写持久状态
Chatbot、摘要器、搜索助手。需要L1+轻量L2。LangSmith或LangFuse都合理。
场景三:多Agent/Agent workflow,写入是只读或边角
需要完整L2。已经在用Honeycomb就直接上Honeycomb Agent Obs;想self-host+强eval就上Arize Phoenix。
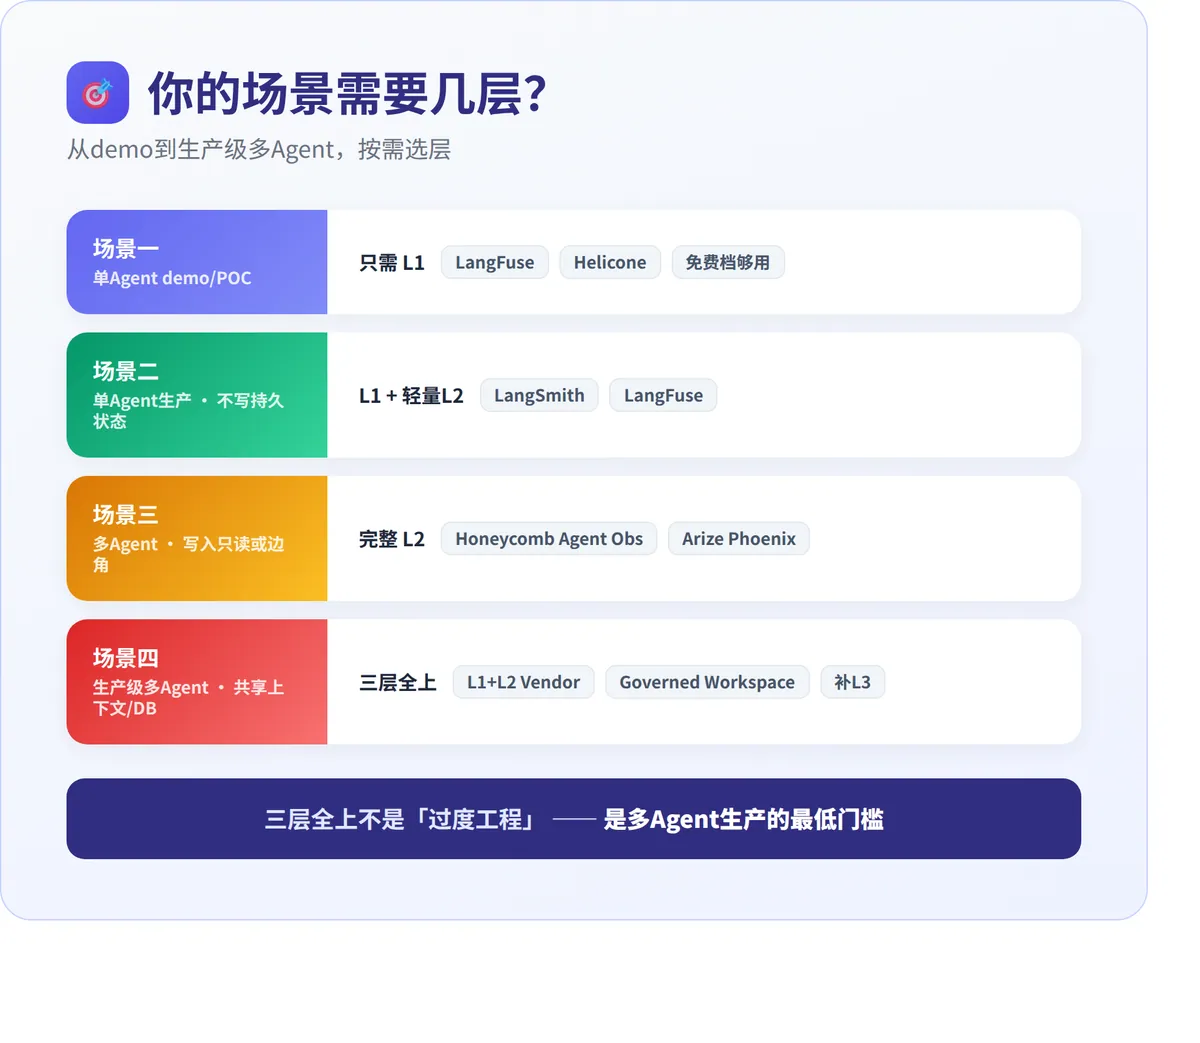
场景四:生产级多Agent,共享上下文/文件/数据库写入
需要三层全上。选一个L1+L2 vendor,再配一个governed workspace补L3——否则下一次Agent写错时,你没有revert按钮。
七平台战场:L2层谁在卷什么
2026年5月,L2层是最拥挤的市场。LangSmith+SmithDB、Honeycomb Agent Observability、Arize AX、LangFuse、Helicone、Phoenix、Superlog七家同时入场。我们把关键差异拎出来:
LangSmith + SmithDB:LangChain深度集成,eval原语丰富,社区最大。代价是vendor lock-in——你的Agent不是基于LangGraph构建,你为一半价值买单。
Honeycomb Agent Observability:十年分布式追踪积累,Agent Timeline在单一时间线上看多Agent运行。Canvas Agent能读trace自动诊断。只有SaaS,long-running Agent容易踩超。
Arize AX + Phoenix:业界最强eval集成——drift detection、ground-truth对比、回归套件。Phoenix开源、本地友好,做dev/staging很好,但生产级多Agent timeline视图相对薄。
LangFuse:开源、self-host友好、价格透明。多Agent timeline UX还在追赶,部分agent-specific原语有「后加」的痕迹。
Helicone:一行proxy集成,不挑Agent框架。更深的Agent内省需要SDK级埋点,proxy给不了。
Superlog:YC投资,为没有SRE的vibe-coding团队设计。配置开销最低,但大流量生产场景口碑还没建立。
三个还没解决的难题
按未来12个月会咬人的频率排序:
1. 跨厂trace schema互通。OpenTelemetry GenAI是好开始,但各家在自己extension上加东西,换后端成本仍然偏高。
2. Agent-on-traces。让Agent debug自己的trace(Honeycomb Canvas Agent是早期尝试)原则上很强,但下限取决于schema。在L3也被instrument之前,诊断都是片面的。
3. L3标准化。「Agent审计日志」没有一个被广泛采用的协议。当前最优解是governed workspace系统+各种自建Git wrapper。
值得注意的是:2026年的可观测性不只是「看」的问题。AWS在Bedrock AgentCore上已经把OpenTelemetry GenAI语义约定做成了基础设施层——OTLP直连CloudWatch、自动创建日志组、预配置环境变量。这意味着可观测性正在从「选哪个工具」变成「怎么接进基础设施」。
但即便如此,L3依然是空白。你的Agent改了数据库的一条记录,AWS能告诉你调了什么API、花了多少token,但不会帮你把那条记录恢复到修改之前。
回到那个周五下午
如果那天你有L3——一份Agent每次写入的diff记录——你不需要翻三万条日志。你打开审计日志,找到那条被覆盖的报价单,看到Agent在15:03:47用一个错误的版本覆盖了正确内容,点击revert,30秒搞定。
客户甚至不会知道这件事发生过。
这就是三层可观测性的价值:不是让你「看见」问题,而是让你「解决」问题。L1让你看见,L2让你理解,L3让你动手。
2026年,只做L1+L2就上线的Agent,就像只买了防火墙没有备份的企业——不是会不会出事的问题,是什么时候出事的问题。
📌 30分钟回滚测试清单
✅ 5分钟内拿到完整trace?→ 你有L1+L2
✅ 15分钟内定位持久状态变更?→ 你有L3的雏形
✅ 30分钟内revert写入?→ 你有完整的三层
❌ 任何一题「不能」→ 你少了一层,下一次事故就是你的
— 全文完 —