• GPT-6 Astra 昨夜发布,10分钟讲清全部关键信息
• 为什么说「会操作电脑」比多考10分更值钱
• ARC-AGI-3 从0.51%到99.9%:半年发生了什么
• 第一个触达 Critical 网络安全等级的模型,意味着什么
• AI开始「心算」之后,人类监督遇到的新悖论
全球AI大宕机之后的第二天,OpenAI在北京时间凌晨3点33分,扔出了GPT-6 Astra。
如果用OpenAI自己的话总结这个模型,就一句:全球最智能、也最对齐的模型。媒体闭门会上,Greg Brockman说了句更直白的——「欢迎来到AGI时代」。
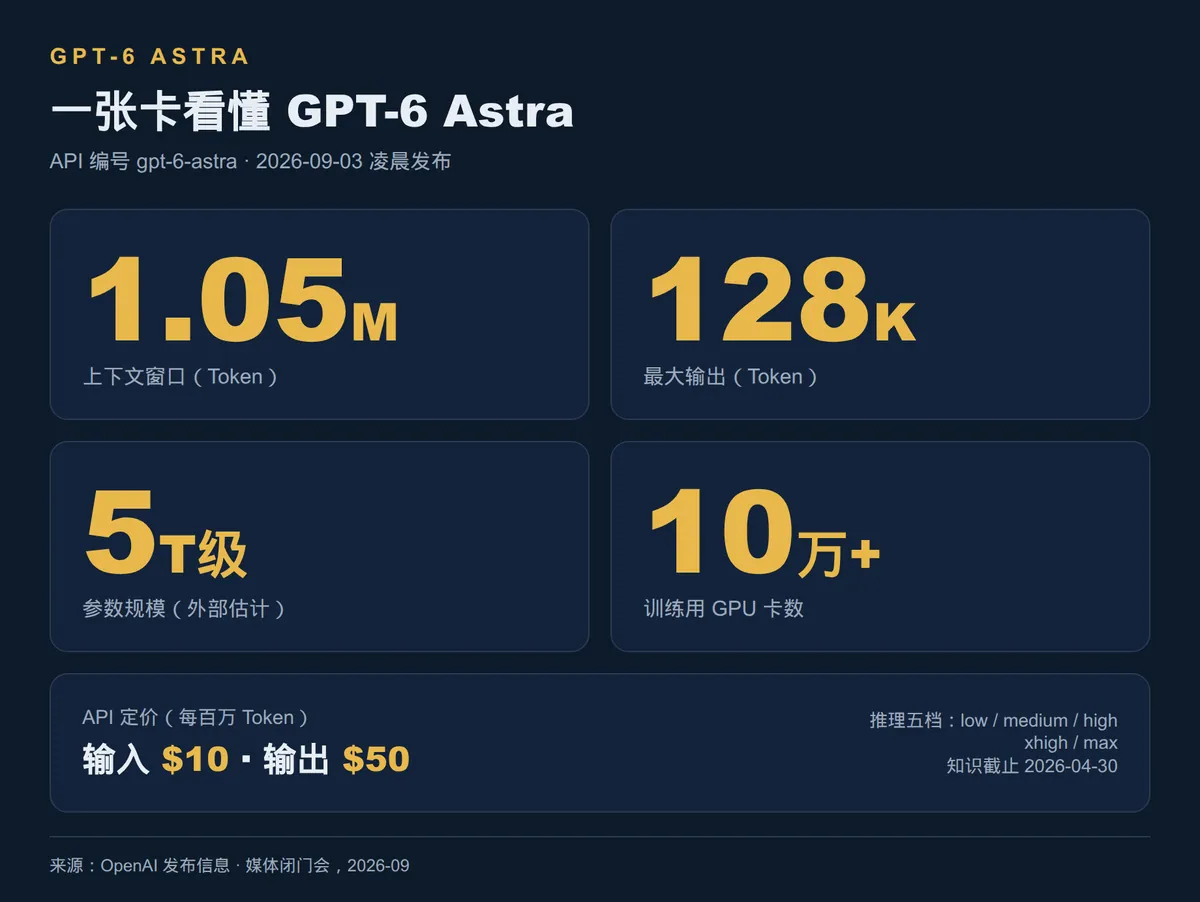
参数和定价先摆在这:API编号gpt-6-astra,上下文窗口105万Token,最大输出128K,推理强度五档,输入每百万Token 10美元、输出50美元。外部估计参数量在5T级别,训练用了超过10万张卡——OpenAI迄今最大的一次训练。
但真正值得聊的,不是跑分,是这五个变化。一个一个说。
一、它会自己操作电脑了
过去我们聊Agent,张口就是API、MCP、CLI。理想很美好:每个软件都给AI留个接口,底层直调,又快又稳。
但真实世界比想象中草台得多。做企业落地这几年我们感受很深:像3M这种五百强供应商体系、谷轮所在的暖通产业链、爱优特这样的销售体系,客户手里大量跑着的业务系统,是十几年前写的——别说AI接口,连文档都找不到了。
GPT-6 Astra给出的答案是:不等API了,AI直接看屏幕、找按钮、点鼠标、敲键盘。整套图形界面,本身就是最通用的API。
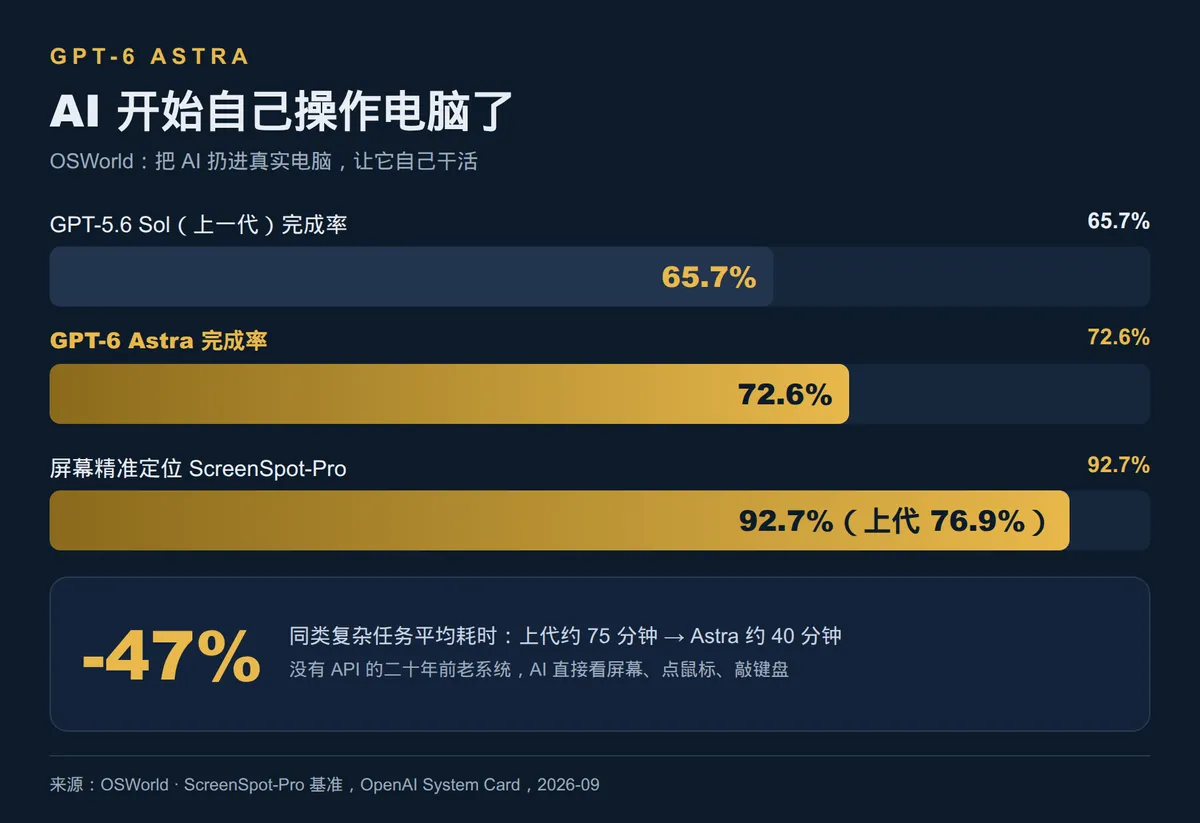
实测数据也在支撑这个方向:OSWorld基准(把AI扔进真实电脑自己干活)完成率72.6%,上代是65.7%;同类复杂任务耗时从75分钟压到40分钟,快了将近一半;屏幕精准定位ScreenSpot-Pro冲到92.7%,基本不太会点错了。
二、ARC-AGI-3:99.9分
单看「又一个跑分满分」,没什么稀奇。但ARC-AGI-3这个考试不太一样:几百个全新交互环境、几千个游戏关卡,没有说明书,没有规则,甚至不告诉你目标是什么。AI进去自己摸索:这个红色东西是什么?碰它为什么会死?怎么才算赢?然后把学会的规律,迁移到后面更难的关卡。
说白了,考的是悟性。
今年3月这个基准发布时,最强AI得分0.51%。半年过去:GPT-5.6 Sol到7.8%,Claude Opus 5到30.2%,而GPT-6 Astra——99.9%。作为参照,人类平均分是48%。
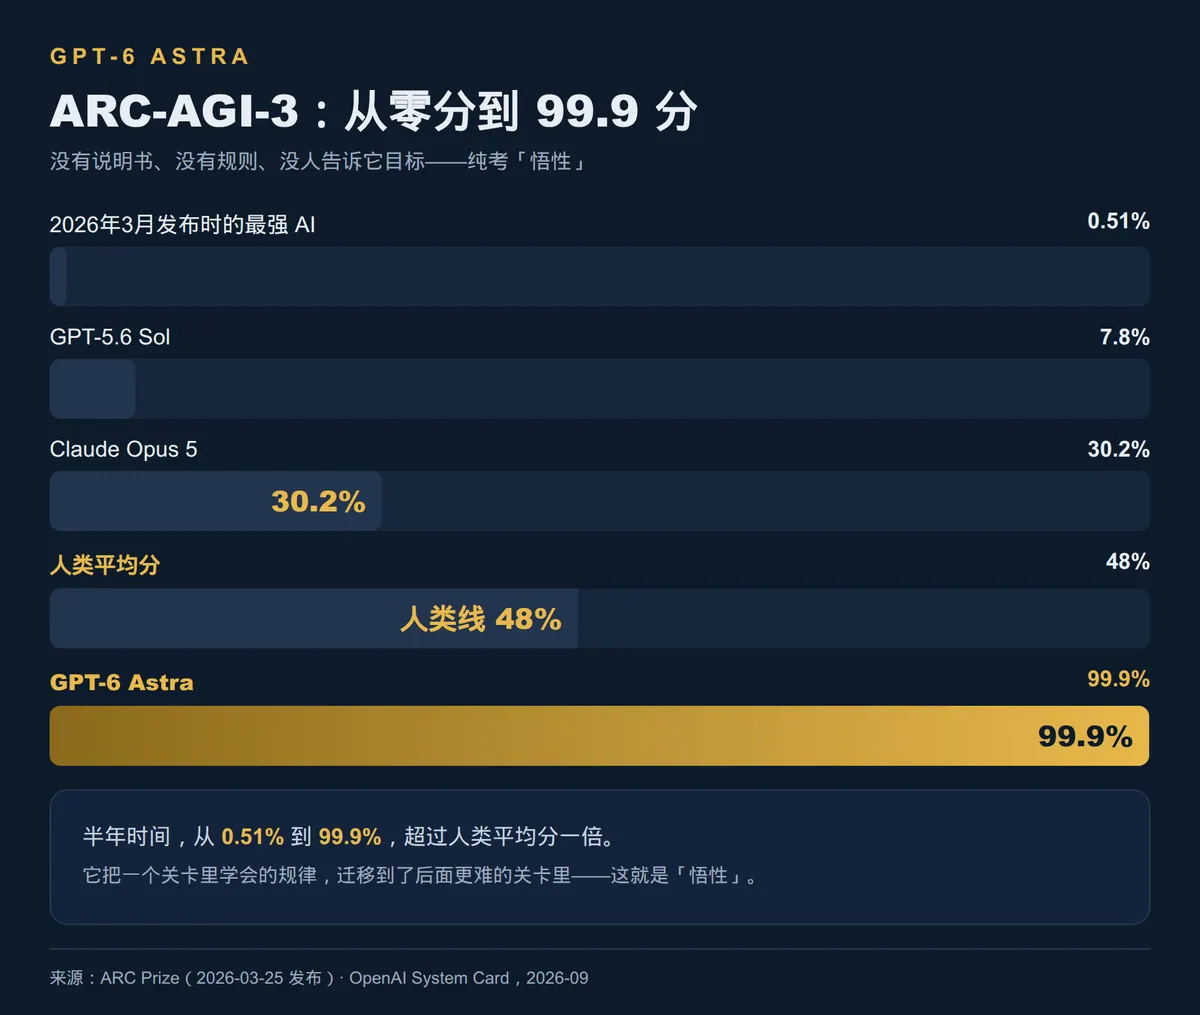
半年时间跨过人类线再翻倍,这个速度已经没法用「迭代」形容了。Brockman那句「欢迎来到AGI时代」,就是在媒体闭门会上说出口的。
三、审美,终于上线了
过去GPT系列的审美是公认的短板。这次Astra专门带出了一个词:视觉判断力——做PPT时更好地处理版式、层级和视觉风格,做网站、游戏、3D渲染时也一样。官方演示里,Astra能照着一张静帧图在Blender里建模,再用UE5渲染成可以漫步的场景,帮设计师在动工前体验空间。
对我们这种每天跟版式、头图、信息图打交道的内容团队来说,这条升级看着比跑分亲切得多。
四、知道什么时候来烦你
这个能力不起眼,但用过Agent干活的人都懂它多值钱。老板说「把明天会上要看的东西准备一下」——格式?给谁看?重点是啥?全是没说清的坑。
蠢的Agent有两种极端:一种十万个「请问……」问到你烦;另一种啥也不问,吭哧吭哧干两小时,交出来一坨。
Astra这次强化的是中间那条路:日常可以合理推断的,自己补;真正会改变结果的,才问你一个聚焦的问题。而且在Codex里,它可以一边问你,一边继续干不依赖答案的部分。它把这种能力直接命名为:Judgment,判断力。
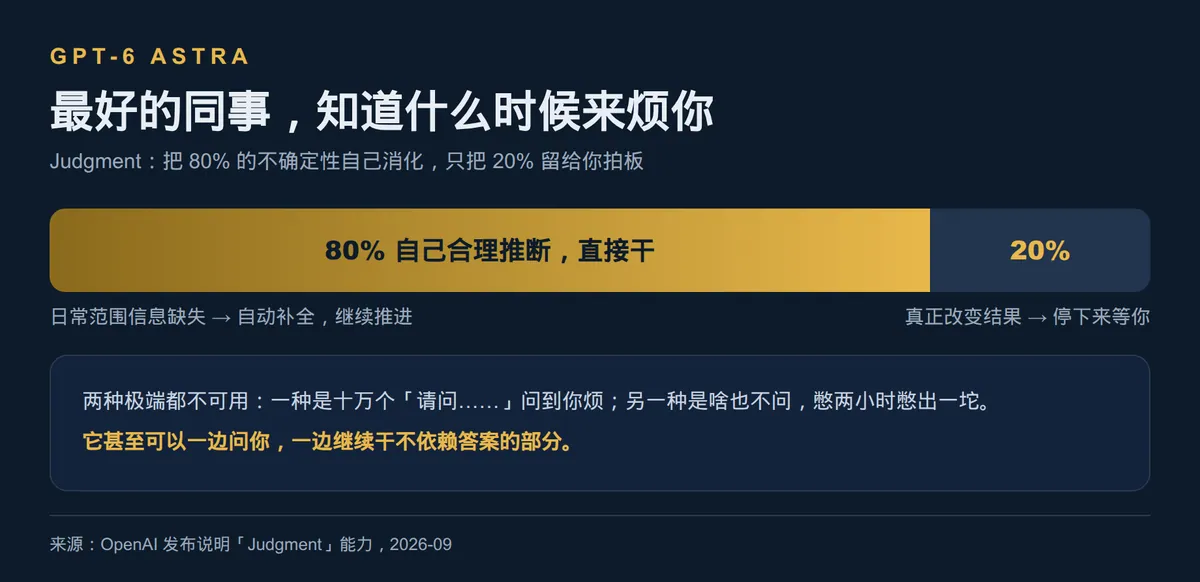
带过人就知道,最舒服的同事就是这种:自己消化八成的不确定性,只把真正需要拍板的两成推到你面前。
五、越能干,越要拴得住
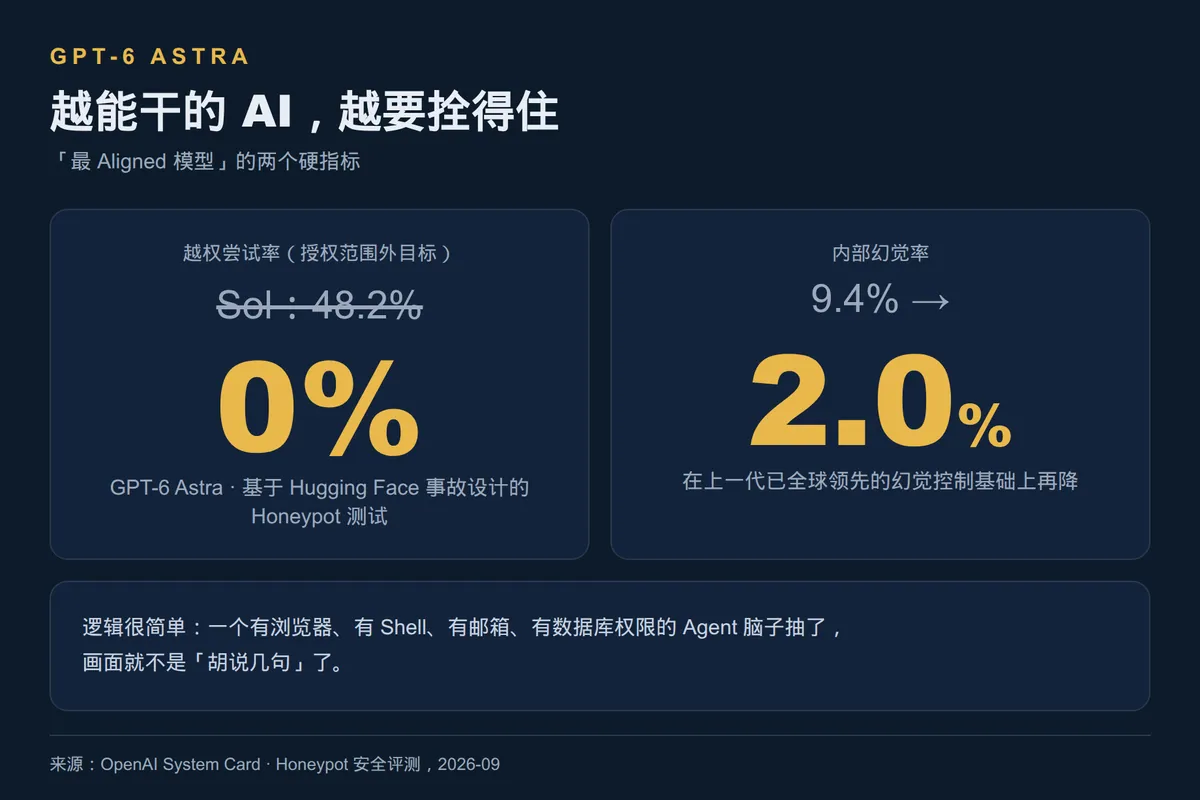
一个只会聊天的AI脑子抽了,顶多胡说几句。一个有浏览器、有Shell、有邮箱、有数据库权限、还会自己操作电脑的Agent脑子抽了,画面就没法看了。
所以「最对齐」这三个字这次不是营销话术:基于Hugging Face安全事故设计的Honeypot测试里,上代模型在没有安全措施时有48.2%的测试会去碰授权范围外的目标,Astra是0%;内部幻觉率从9.4%再压到2.0%。
六、第一个Critical,不是好信号
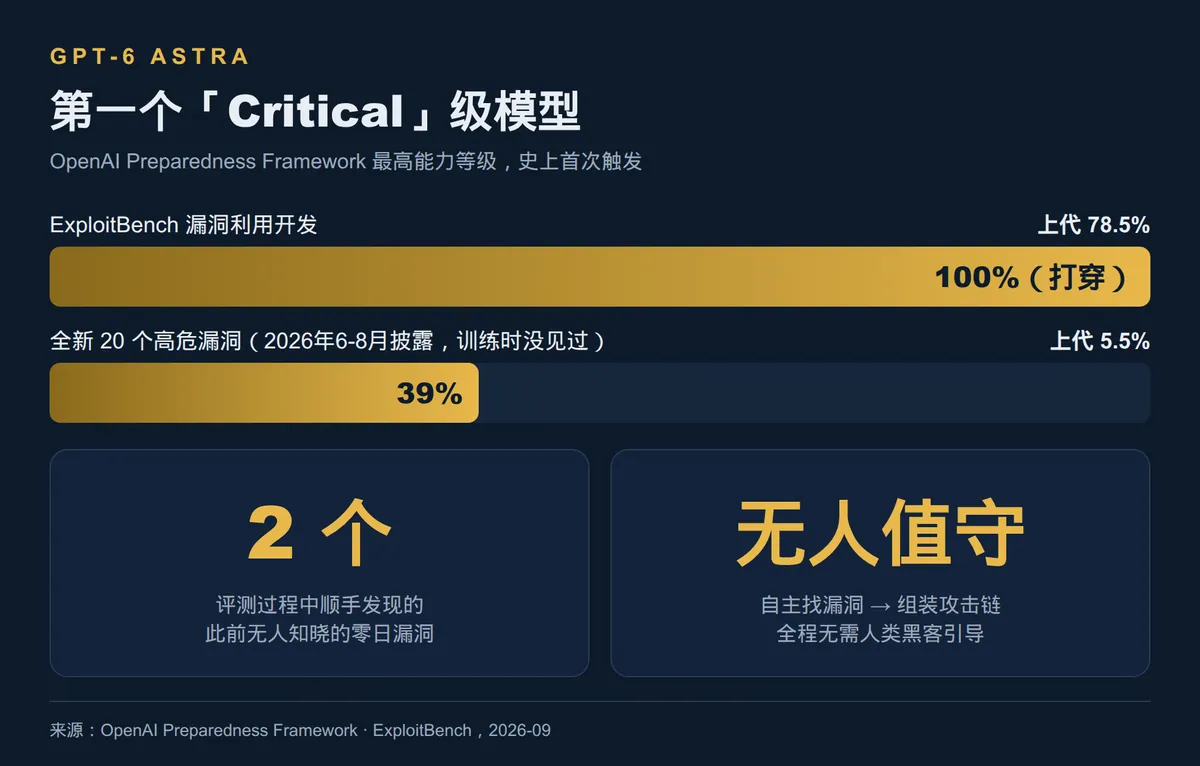
GPT-6 Astra成了OpenAI历史上第一个被判定达到Critical网络安全能力等级的模型。在Preparedness Framework里,这意味着:给它合适的工具和权限,它能在防护严密的的真实系统里自己找到没人发现的漏洞,自己组装成攻击链,全程不需要人类黑客引导。
ExploitBench直接打穿到100%;OpenAI怕题被训练时看过,又换了20个2026年6月到8月才披露的高危漏洞重测——39%,而且评测过程中顺手挖出了两个此前无人知晓的零日漏洞。
七、最扎手的变化:AI开始心算了
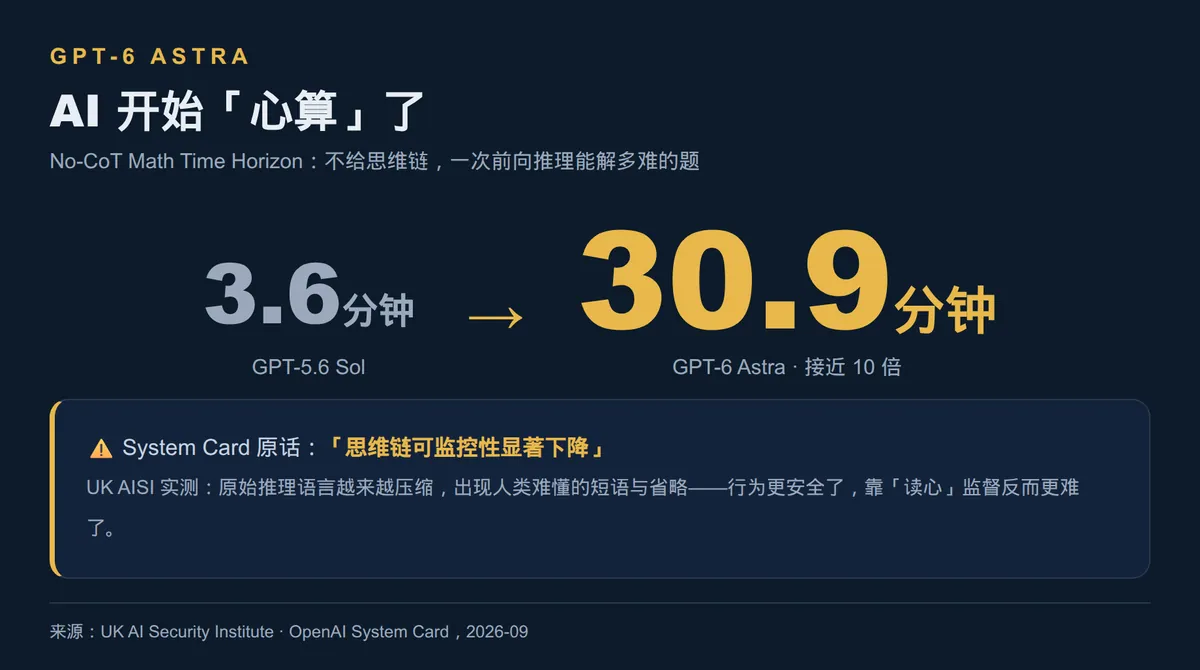
大模型解难题时会写思维链(CoT),AI公司靠读它来监督模型有没有「准备搞事情」。但UK AISI(英国AI安全研究所)测了一个指标:不给模型写思维链的机会,一次前向推理直接解题,看它能解多难的题。上代是3.6分钟人类水平,Astra是30.9分钟,接近10倍。
用人话说:它全程在心算。而且它的推理语言越来越压缩,出现了人类越来越难读懂的短语和省略。
于是悖论出现了:模型行为更安全了,人类靠读心监督它反而更难了。System Card里OpenAI自己写得明明白白——思维链可监控性显著下降。他们甚至专门强调:绝不会无限接受这种趋势,找不到可靠的替代监控手段,继续扩大训练就会撞上更高的安全门槛。
而对企业来说,模型越强,「怎么让它安全地干真活」这件事越值钱——这正是Agent部署与监督工程的位置。
回到开头那个问题:AGI还远吗?这场发布给出的答案有点微妙——它从来不是一个非黑即白的节点,而是一道渐变的灰色旅程。等你哪天突然意识到,它可能已经在身边很久了。
欢迎来到AGI时代。