• 为什么你的AI助手用着用着就"忘了"之前的对话
• Context Window不是记忆,而是随时清空的RAM——这个认知偏差毁了多少项目
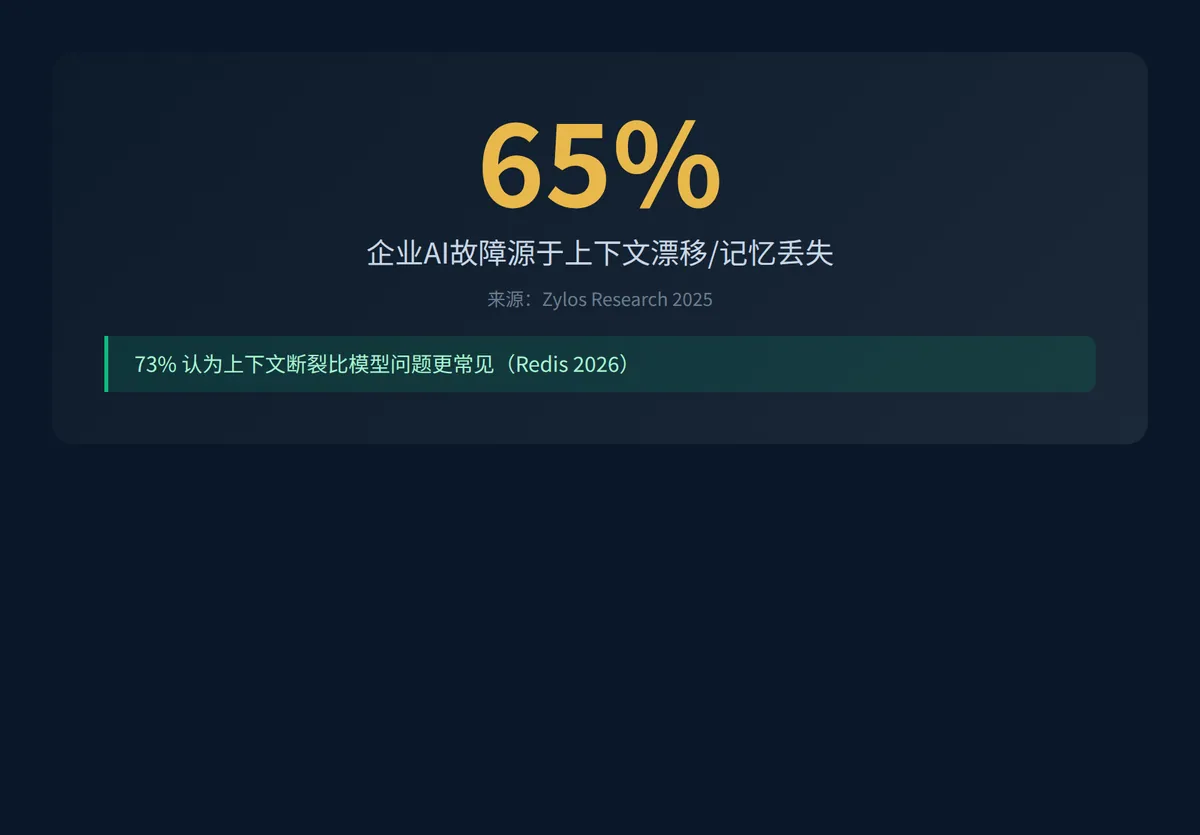
• 65%企业AI故障的真实元凶:不是模型不行,是上下文断了
• 三款开源记忆系统横向对比,帮你选对"AI大脑"的外挂方案
你训练了三个月的销售助手,某天突然对你说:「抱歉,我不记得您之前提过的需求。」
你精心搭建的多Agent协作流程,A agent刚分析完客户画像,把活儿交接给B agent,B agent开口就是一句:「请问您是做什么行业的?」
这不是AI偷懒。这是你的AI「失忆」了。
Zylos Research的数据显示,2025年企业AI项目中,65%的失败源于上下文漂移或记忆丢失——不是模型太笨,而是Agent在多步推理中把自己说过的话给忘了。Redis 2026年的行业调研进一步验证:73%的AI从业者承认,上下文断裂比模型本身的问题更常见。
问题的根源,不是技术不够先进,而是我们从一开始就把「Context Window」错当成了「长期记忆」。
一、Context Window ≠ 记忆
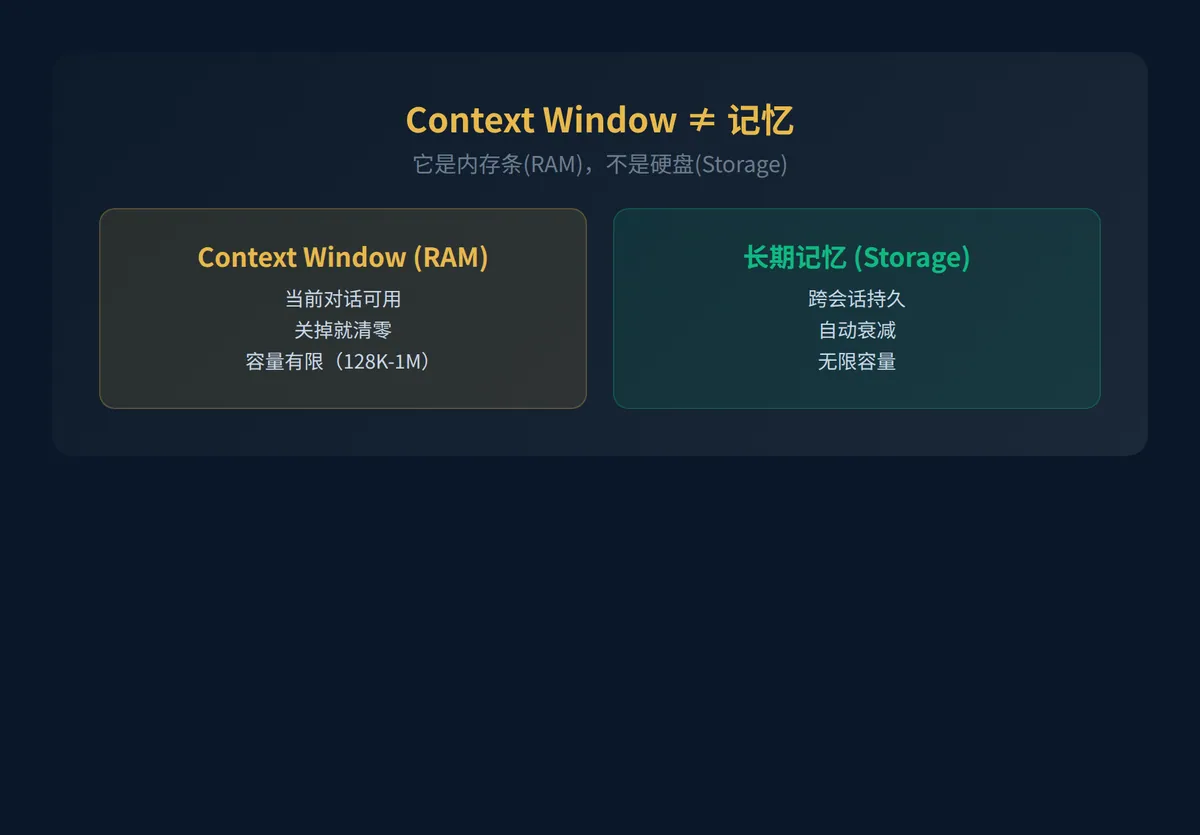
Mem0团队在2026年发表了一篇被广泛引用的文章,标题直白得像一记耳光:Context Window is RAM, Not Storage。翻译过来就是:上下文窗口是内存条,不是硬盘。
这个类比精准得可怕。你的电脑有32GB内存,跑着各种程序,但一关机——内存里的一切全部清零。下次开机,你得从硬盘里重新加载。Context Window就是这个「内存条」:它让AI能在当前对话中「看到」上下文,但对话一结束,或者上下文超出窗口大小,之前的所有信息就蒸发了。
更致命的是,大多数开发者在设计Agent时,把所有信息——用户偏好、历史对话、任务状态、决策依据——全塞进了Context Window。就像你把所有文件都存在内存里而不存硬盘。一旦对话变长、窗口撑满,系统就开始「挤」最早的内容。AI看到的信息越来越少,决策质量直线下降。
二、为什么Agent会在任务中途"断片"
如果你只用一个Agent跑单轮对话,Context Window的问题可能还不明显。但2026年的企业AI早已不是单兵作战——多Agent协作、长周期任务、跨会话记忆,才是真实场景。
syncsoft.ai的报告指出,AI Agent系统消耗的token大约是单次对话的15倍。每次Agent之间交接上下文,都是一次信息传递。一旦传递中丢失了关键决策依据,后面所有步骤都建立在错误的基础上——这就是「上下文漂移」。
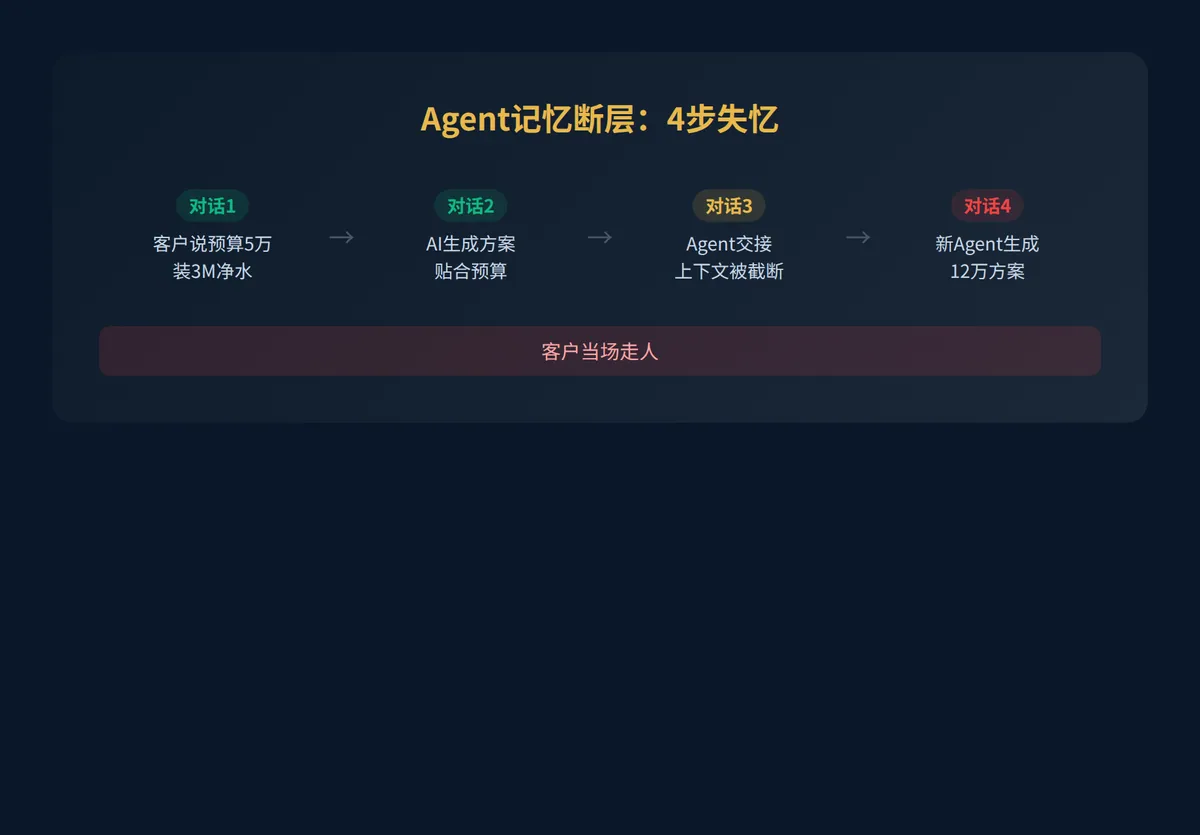
我见过的真实案例:一家3M净水设备经销商用AI做客户方案生成。前几轮对话中,客户详细描述了水质问题、预算范围、安装条件。结果在第四轮对话时,Agent突然忘记了客户预算只有5万,生成了一套12万的方案。客户当场走人。
这不是个案。谷轮(Copeland)在部署AI供应链助手时也遇到过类似问题:Agent分析了上个月的库存数据给出建议,下个月却把同样的建议原封不动地搬出来——它「忘了」库存已经变了。
三、解法:给AI装上"长期记忆"
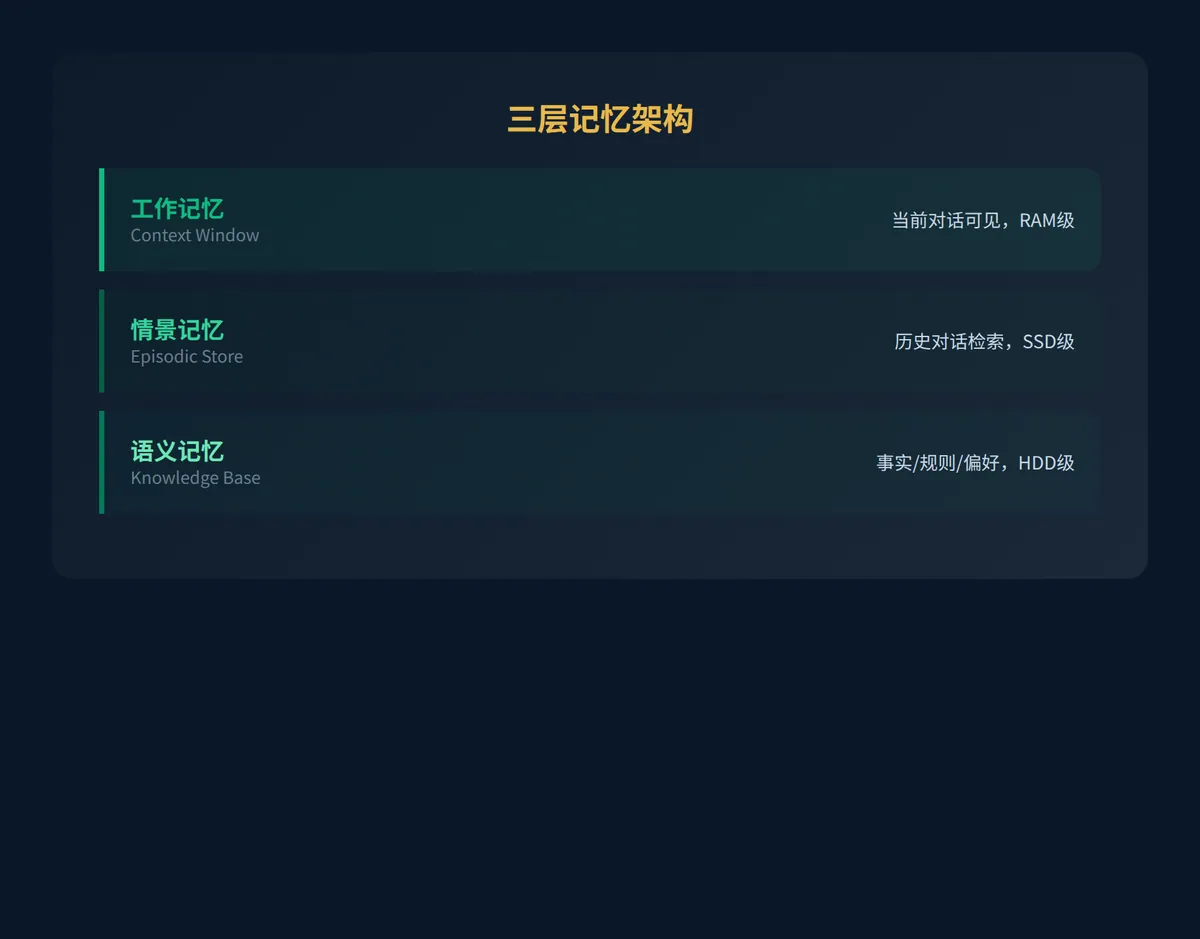
好消息是,业界已经在用成熟的架构解决这个问题。核心思路很简单:把Context Window当RAM用,把外部存储当硬盘用,让Agent学会在两者之间「翻页」。
Oracle的开发者博客把这套架构叫做「虚拟上下文」——Agent需要什么信息,就从外部存储里调进来,不需要的就踢出去。就像操作系统的虚拟内存机制。
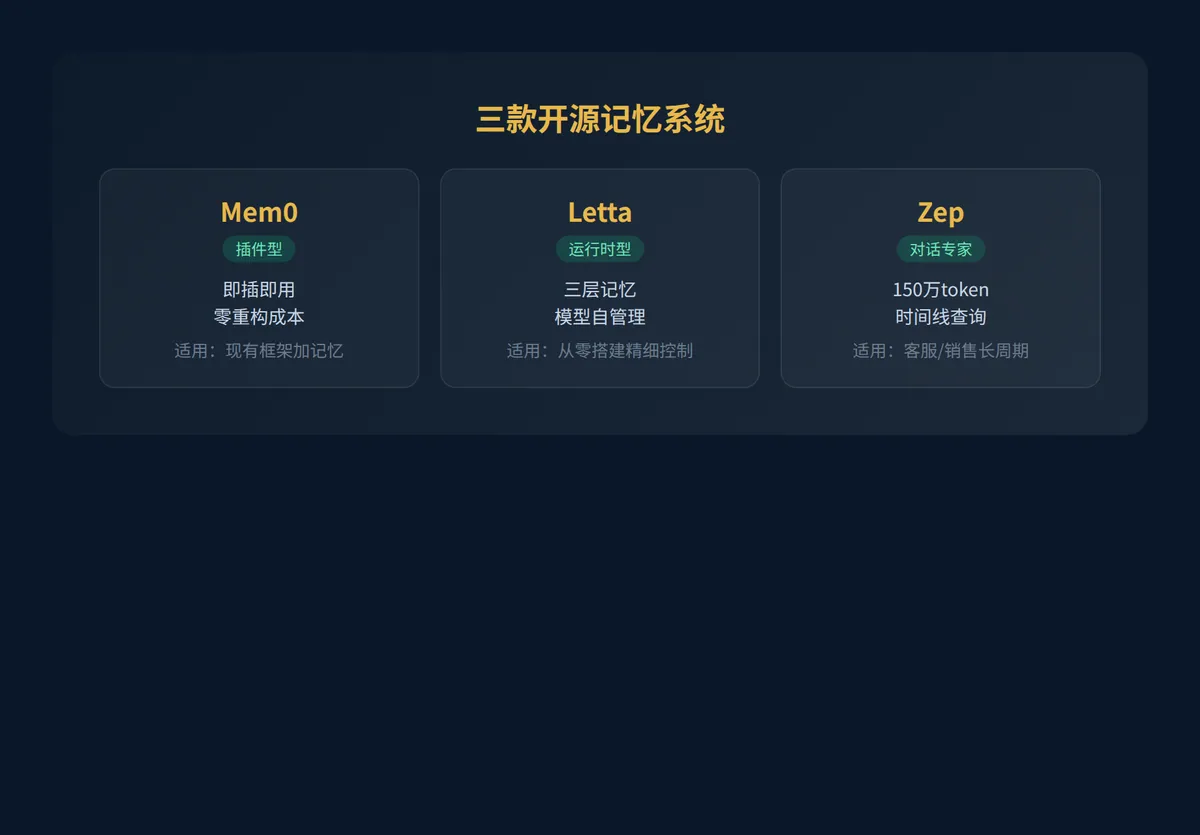
目前开源社区有三款主流记忆系统,各有侧重:
Mem0——轻量插件型。像给Agent加了一层「记忆外挂」,嵌入现有架构几乎零改动。适合已经跑起来、不想重构的项目。它的核心卖点是「即插即用」:你不需要换框架、不需要重建Agent,只要在调用层加一个Mem0 SDK,它自动帮你管理记忆的存取。
Letta——全量运行时型。它不只是记忆层,而是一个完整的Agent运行环境,模型自己管理三层记忆(核心记忆/召回记忆/归档记忆)。适合从零搭建、对记忆控制要求高的场景。代价是复杂度高,需要重新设计Agent的工作流。
Zep——长期对话专家型。专攻超长上下文场景(实测支持150万token),擅长时间线查询和记忆衰减。适合客服、销售等需要跨越数周甚至数月维护客户上下文的场景。
四、实操:三步给你的Agent装上记忆
如果你正在部署AI Agent,不管是客服、销售还是内部工具,下面三步是最低成本的记忆升级路径:
第一步:识别你的Agent的"记忆断点"。回顾过去一个月的Agent失败案例,统计有多少次是「Agent忘记了之前对话中的信息」。如果超过30%的失败与上下文丢失有关,你就需要记忆系统了。这一步的关键是用数据说话——不是「感觉AI有时候会忘」,而是「在100次Agent交互中,有35次因为上下文丢失导致了错误输出」。
第二步:选型——根据你的技术栈做减法。已有Agent框架(LangChain/LlamaIndex等)→ 优先Mem0(插件式接入);从零搭建、对记忆有精细控制需求 → Letta;客服/销售等长周期场景 → Zep。不要贪多——先用一个跑通核心场景,再考虑扩展。
第三步:设计记忆的"衰减规则"。不是所有信息都值得永远记住。3M的案例告诉我们,客户的预算信息保质期可能是3个月,而水质数据可能每周都在变。好的记忆系统不是「记住一切」,而是「知道什么时候该忘」——让Agent自动淘汰过时信息,保留高频引用的决策依据。
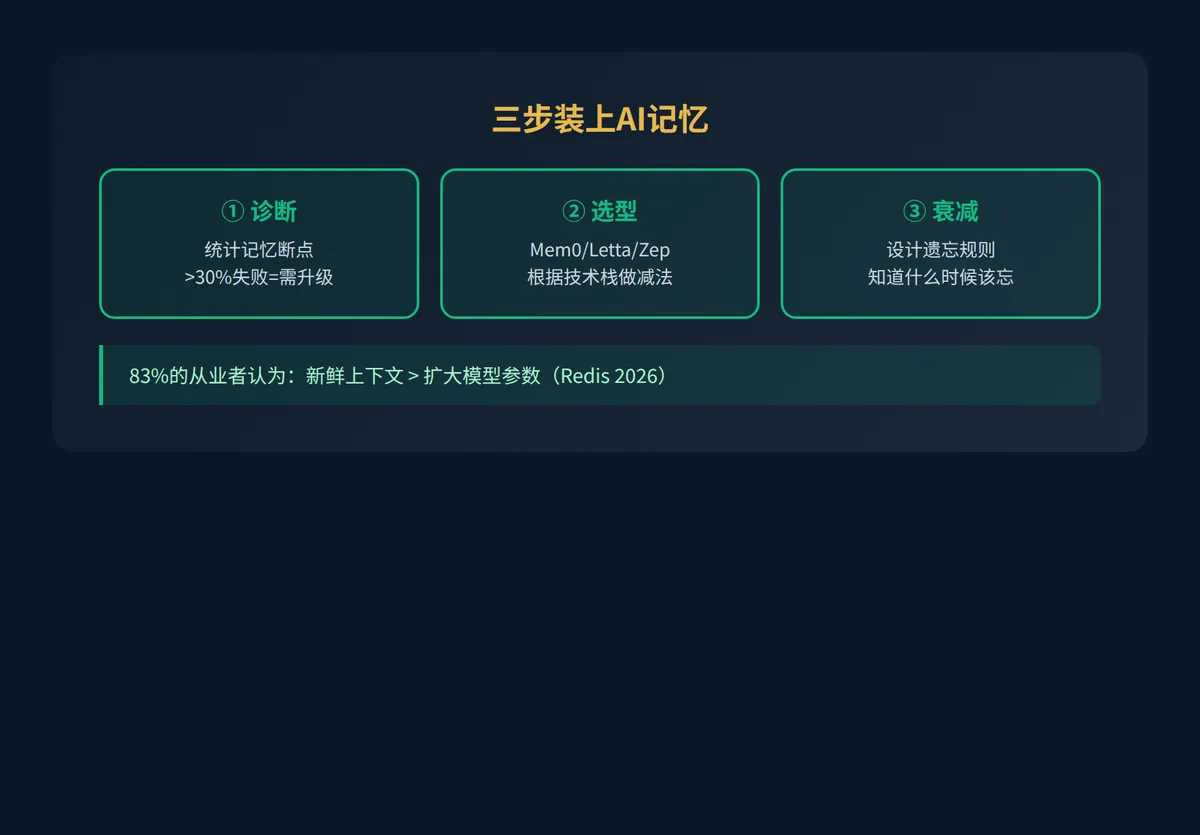
Redis的调研里有一组数据特别值得注意:83%的从业者认为,提供新鲜的上下文比扩大模型参数更重要。这句话翻译成大白话就是——与其花钱换更大的模型,不如先把Agent的记忆架构搭好。
你花在模型上的钱,可能有一半是给「失忆」擦屁股。一个装了记忆系统的7B小模型,效果可能好过一个200B但没有记忆的大模型。这不是夸张——2026年已经有大量实践验证了这个结论。
说到底,AI Agent的记忆问题,本质上不是一个AI问题,而是一个工程问题。模型负责思考,记忆系统负责「不忘记思考过的东西」。把这两件事拆开、分别做好,你的Agent就不会再「失忆」了。