📖 导读:阅读本文你将获得:
• 看懂 AI 智能体"健忘"的技术根因——不是笨,是天生无记忆
• 掌握三步给智能体装上"长期记忆"的实战方法
• 一套可复用的记忆管理检查清单,防止智能体上岗即退化
• 三个真实客户案例:3M、谷轮、思帕如何解决智能体记忆断裂
AI 上岗就健忘?
—— 给你的 AI 智能体装上"长期记忆"
上个月,我们帮一家制造企业部署了客服智能体。上岗第一周,效果不错,客户问题响应时间从十分钟缩到几十秒。
第二周,问题来了。
有个老客户第三次来咨询同一条产品线的报价,智能体完全不记得前两次聊过什么,又从头问了一遍基本信息。客户直接发火:「你们这个机器人有病吧?问了三遍还让我重新说?」
这不是个例。AWS 在 2025 年底发布的 Agent 基础设施报告里给了一个扎心的结论:大语言模型本质上是无状态的(stateless)。每次对话,它都是一张白纸。你以为它记得你上周交代的事,其实它连你是谁都不知道。
翻译一下:你招了个新员工,每天早上失忆一次,你还得重新做入职培训。
为什么智能体天生"健忘"?
问题出在大语言模型的底层机制。
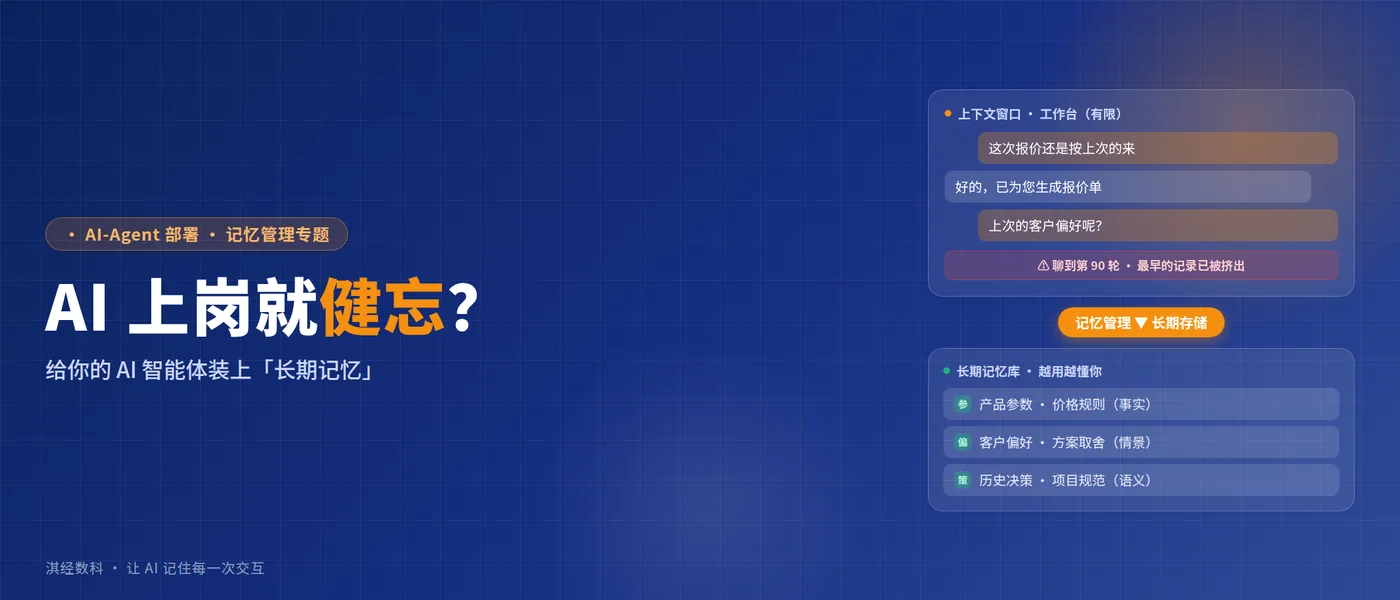
每个大模型都有一个"上下文窗口",可以理解为它的"工作台"——它只能看到工作台上的东西。工作台满了,最早放上去的东西就被推出去。你跟它聊了一百轮对话,前九十九轮的内容,它根本看不到。
这就造成了两个致命问题:
第一,跨会话失忆。你今天跟智能体聊了两个小时,明天再开新对话,它什么都不记得。上次的结论、上次的修改意见、上次你特意强调的规则——全部归零。
第二,长对话遗忘。即使在同一次对话里,聊得久了,前面的信息也会被"挤出去"。你让它写一篇方案,写到第五段的时候,它已经忘了第一段你定的核心论点。
知乎上一篇技术综述把这个现象总结得很精准:2026 年智能体赛道的核心壁垒,已经不是"模型够不够聪明",而是"记忆管理够不够强"。
三个真实案例:记忆断裂怎么修
案例一:3M——从"每次重新教"到"一次教会,永久生效"
3M 作为全球 500 强企业,内部流程极其复杂。他们部署的智能体需要处理产品参数查询、报价生成和审批流转三个环节。最初的问题是:每次新对话,智能体都要重新加载产品参数库,响应延迟高达 30 秒。
解决方案是引入"事实记忆层"——把产品参数、价格规则、审批流程这些相对固定的信息,从对话上下文中抽离出来,存入外部知识库。智能体每次启动时,先加载事实记忆,再处理当前对话。响应时间从 30 秒降到 3 秒,而且永远不会"忘记"产品参数。
案例二:谷轮——客服智能体的"带教期"记忆
谷轮的客服智能体遇到的问题更典型:同一个客户一周内问了三次同样的退换货政策,智能体每次都像第一次听到一样重新解释。客户体验极差。
他们用了一个叫"情景记忆"的方法——不是记所有对话,而是只记关键事件。比如客户上次提出的投诉、上次给出的解决方案、上次确认的退换货进度。这些信息被打上时间戳和事件标签,存入长期记忆。下次同一客户来咨询时,智能体自动调取相关情景,不用客户重复自己。
效果:客户重复说明问题的次数降了七成,满意度提升明显。
案例三:思帕——跨项目经验的"记忆传承"
思帕面临的问题更高级:他们的智能体需要同时服务多个项目团队,每个团队的规范、偏好、历史决策都不同。如果每个项目都从零开始,效率极低。
他们的方案是"语义记忆"——不是记原始对话,而是从对话中提炼出结构化的知识。比如"A 项目组偏好简洁方案"、"B 项目组要求所有数据必须脱敏"、"C 项目组上周否决了方案 X"。这些提炼后的知识跨项目共享,智能体在服务新项目时,能自动参考历史经验。
这就是从"记住对话"到"记住知识"的跃迁。
三步给智能体装上"长期记忆"
说了这么多技术概念,落地怎么做?三步。
第一步:区分"该记什么"和"不该记什么"。
不是所有对话都值得记。记多了,检索变慢,质量反而下降。核心原则:只记对后续交互有价值的信息。比如客户偏好、业务规则、历史决策、常见问题的解决方案。闲聊、寒暄、一次性查询——过期就删。
AWS 的最佳实践报告给了一个判断标准:这段信息,下次对话时如果不知道,会不会导致智能体犯错或效率下降?会,就记。不会,就不记。
第二步:选对记忆架构。
2026 年主流的记忆方案有三条路:
Mem0——开源记忆框架,支持四种记忆类型(工作记忆、事实记忆、情景记忆、语义记忆),轻量灵活,适合中小项目快速上手。GitHub 上已经有大量企业级实践。
Letta(原 MemGPT)——核心思路是"虚拟内存",把有限的上下文窗口当成"内存",把外部存储当成"硬盘",自动在两者之间调度。适合需要超长上下文的复杂场景。
LangMem——LangChain 生态的记忆模块,和 LangGraph 深度集成,适合已经在用 LangChain 的团队。
小团队用 Mem0,复杂场景用 Letta,已有 LangChain 生态的用 LangMem。别纠结,先跑起来。
第三步:定好记忆更新规则。
记忆不是存进去就完了,要定期清理和更新。规则很简单:
• 每 3-5 轮对话,自动触发一次"记忆压缩"——把近期对话提炼成摘要存入长期记忆
• 关键事件(完成任务、场景转换、客户投诉)立即写入记忆
• 过时信息定期衰减——超过 30 天未被引用的事实记忆,标记为"低优先级"
• 用户可以主动要求"记住这个"或"忘掉那个"
这就像带一个新员工:不是把所有资料一股脑塞给他,而是每天下班前花五分钟复盘——今天学到了什么、记住了什么、哪些该留、哪些该忘。
记忆管理的底线思维
说一个容易被忽略的风险。
智能体记住了不该记的东西——比如客户的敏感信息、内部的价格底线、未公开的商业策略——这是安全事故。2026 年的企业级 Agent 平台,安全治理已经从"可选项"变成了"刚需"。
OpenAI 在 2026 年推出的 Frontier 平台,核心卖点之一就是"记忆与审计策略"——每个智能体的每条记忆,都要有明确的权限控制和审计日志。谁创建的、什么时候创建的、谁有权访问、什么时候过期,全部可追溯。
所以,给智能体装记忆的同时,必须同时装上"记忆护栏":什么能记、记多久、谁能看、什么时候删。没有护栏的记忆系统,比没有记忆更危险。
记忆是智能体的基础设施,不是可选项。没有记忆的智能体,每次对话都是第一天上班的新员工——永远在做入职培训,永远无法积累经验。
2026 年,AWS、阿里云、腾讯云都在抢占 Agent 记忆管理的基础设施位置。这个赛道的胜负手,不在于谁的模型更聪明,而在于谁的智能体能"记住"更多、"忘掉"更准、"回忆"更快。
你的竞争对手的智能体,可能已经记住了过去半年所有客户的偏好和历史决策。你的智能体,明天早上醒来还记得今天说过什么吗?
别等了。先给你的智能体装上记忆,哪怕只是一个最简单的事实记忆层。装上之后你会发现:它不再是每天失忆的新员工,而是一个越用越懂你的老同事。
上海淇经数字科技有限公司
— 全文完 —